
Process Twin: fra sensorsignal til godkjent arbeidsordre
Process Twin er demonstratoren vår for prediktivt vedlikehold i prosessindustrien: 32 simulerte fabrikker, NVIDIA-modeller på en lokal GPU og mennesker som godkjenner hver handling. Her er hva den viser, hva AI er god til når datamengdene blir store, og hvordan vi leverer.
 Jon Gottfred AndersenStyreleder og hudlege
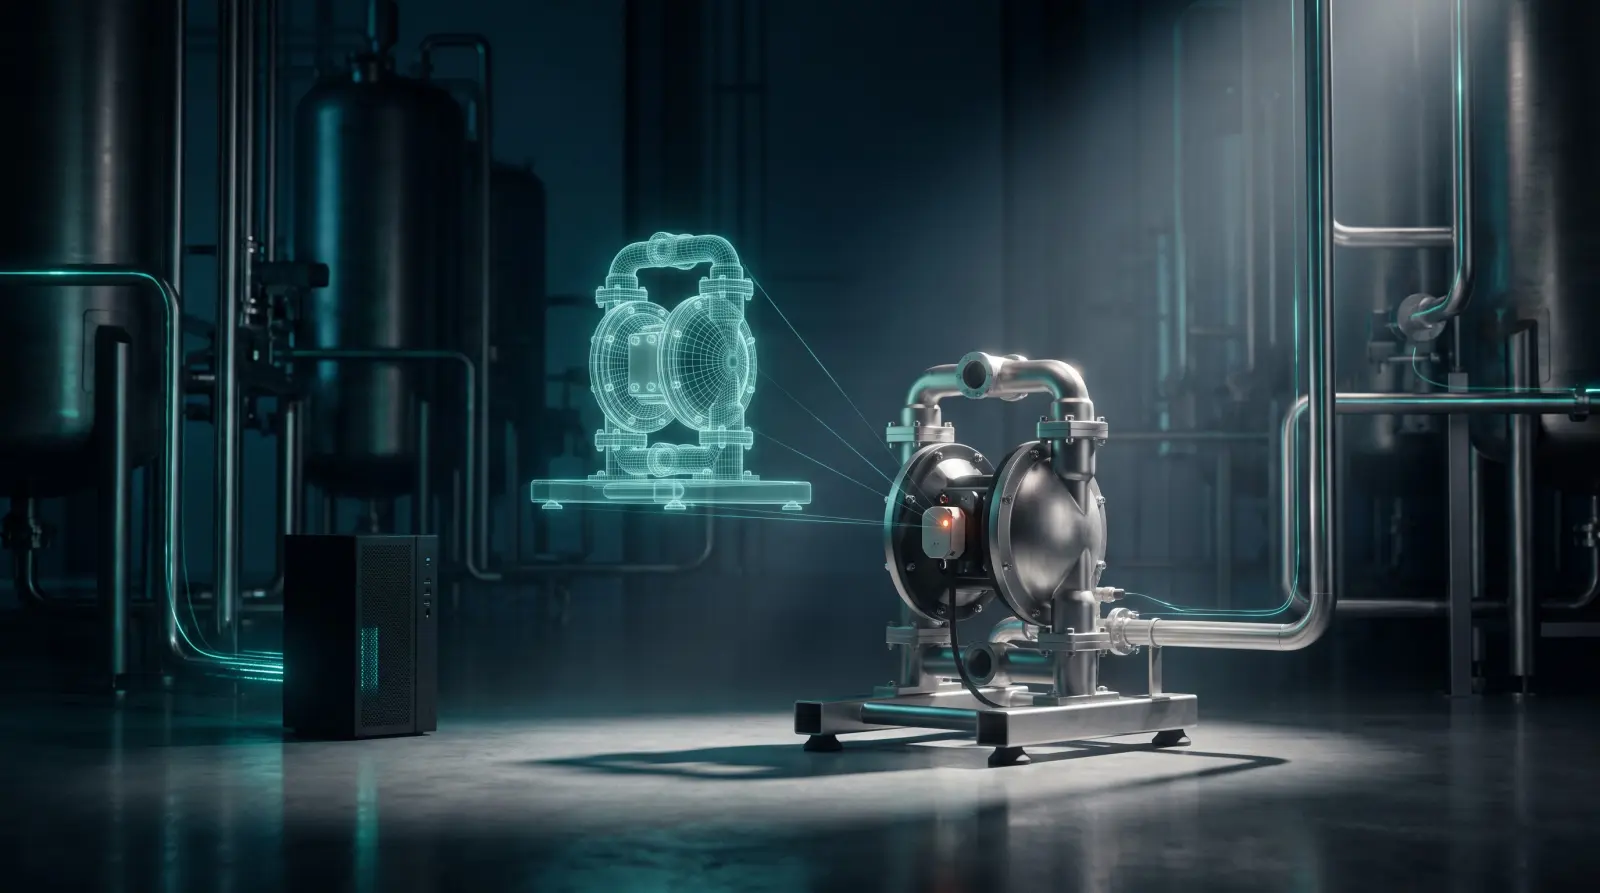
En membran i en pumpe slites ikke over natten. Volumet per slag synker litt for hver uke, pumpa går litt fortere og bruker litt mer trykkluft for å levere det samme. Ingen av målingene bryter en alarmgrense før membranen ryker, og da står linja.
Signalene som kunne ha varslet, finnes som regel allerede: i frekvensomformere, PLS-er, sensorer og arbeidsordrehistorikk. Det som mangler, er noen som leser tusenvis av signaler samtidig, ser sammenhengen mellom dem og gjør funnet om til en planlagt jobb. Det har vi bygget Process Twin for å vise.
Process Twin er en fungerende demonstrator, og dere kan teste den selv på pt.skjld.cloud. Én ting først: Alle anleggsdata i demoen er simulerte, og koblingene mot ERP og innkjøp er etterligninger. Metoden er den vi ville kjørt på deres data. Tallene er det ikke.
Kort fortalt
- Process Twin følger et avvik hele veien: signal, AI-varsel, vedlikeholdsvindu, arbeidsordre og deler, godkjenning og tilbakemelding fra teknikeren.
- Prediktivt vedlikehold flytter jobben fra havari til planlagt stans. Hvor mye det er verdt, måles på anleggets egne data før noen snakker om utrulling.
- AI er sterkest der mennesker kommer til kort: mange signaler samtidig, langsomme trender, sammenligning på tvers av anlegg og mønstre i tid.
- Demoen kjører lokalt på NVIDIA-maskinvare, med NVIDIAs Kumo-modeller for tidsserier og en lokal språkmodell som forklarer funnene.
- Vi leverer onsite i anlegget, lokalt fra egne servere i Sandefjord, i sky og sammen med eksterne partnere og leverandører.
Hva er Process Twin?
Process Twin er en digital tvilling av drift og vedlikehold i prosessindustri. Demoen simulerer en flåte på 32 prosessfabrikker med batchproduksjon: 87 linjer, 1 445 modellerte komponenter og 5 148 signaler. Anleggene har ulik alder og automasjonsgrad, fra manuelle anlegg med eldre PLS-er til helautomatiserte anlegg med DCS, slik en virkelig flåte gjerne har.
Det kommer inn rundt 700 målinger i sekundet, over 60 millioner i døgnet, og de lagres i en tidsseriedatabase. Oppå dette ligger analysene: tilstand og estimert restlevetid per komponent, varsler, utkast til arbeidsordrer, lager og bestilling, energi, OEE og kvalitet, sammenligning mellom anlegg, hva-om-beregninger og en storskjermvisning for kontrollrommet. Hele løsningen, inkludert AI-modellene, kjører på én maskin hos oss: en Dell Pro Max med NVIDIA GB10.
Tanken bak er enkel: signal, kontekst, beslutning, handling. Et varsel er lite verdt hvis det ikke ender som en jobb noen har godkjent, med riktige deler på plass til riktig tid.
Ett forløp: membranpumpa
Den guidede gjennomgangen i demoen følger én membranpumpe gjennom seks steg.
- Signal. Volum per slag er flow delt på slagfrekvens. Når membranen slites, synker volumet per slag. Pumpa må gå fortere og bruke mer trykkluft for å holde samme flow.
- AI-varsel. Varselet kommer med havaririsiko for de neste 30 dagene, tid til tiltak med en konkret frist og en konfidens. Konfidensen er satt sammen av modellkvalitet, signalstyrke og om slitasje og levetidstrend peker samme vei, og begrunnelsen står ved siden av tallet. Da vi skrev dette, viste demoen 71 prosent risiko, 21 dager til frist og 77 prosent konfidens for denne pumpa.
- Vedlikeholdsvindu. Systemet foreslår den timen med lavest forventet last på linja mellom «delene er klare» og fristen, og viser alternativer. Planleggeren kan velge et annet vindu.
- Arbeidsordre og deler. AI lager et utkast til arbeidsordre. Delene sjekkes mot pumpemodellen, slik at varianter som ikke passer, blir avvist. Utkastet viser lokalt lager, lager i regionen med overføringstid og ledetid fra leverandør.
- Godkjenning. Arbeidsordren og innkjøpet godkjennes eller avvises hver for seg. Ingenting går videre uten et menneske.
- Utførelse og læring. Teknikeren bekrefter om diagnosen stemte, og hva årsaken faktisk var. Svaret lagres på hendelsen og kan brukes når modellen valideres senere.
Prediksjonen er et estimat som må kontrolleres mot faktisk tilstand. Derfor er godkjenningen og tilbakemeldingen en del av forløpet.
Hva dere får igjen for prediktivt vedlikehold
Vedlikehold drives i hovedsak på tre måter. Reaktivt vedlikehold venter til noe ryker. Forebyggende vedlikehold bytter deler etter kalender eller driftstimer, enten de er slitt eller ikke. Prediktivt vedlikehold, eller estimert vedlikehold om man vil, planlegger jobben ut fra estimert tilstand og restlevetid for hver enkelt komponent.
Gevinstene kommer flere steder:
- Færre uplanlagte stopp. Jobben gjøres i et vindu dere velger selv, i stedet for midt i en batch.
- Kortere reparasjoner. Når feilen er varslet, er arbeidsordren skrevet og delene reservert før teknikeren går ut.
- Deler i tide, uten overfylt lager. Behovet regnes mot lager og innkommende leveranser, bestillingsdatoen settes ut fra ledetiden, og forsinkelser flagges. Det gir færre hastebestillinger.
- Riktig levetid på delene. Komponenter byttes når tilstanden tilsier det. Dere slipper både å bytte for tidlig og å kjøre til havari.
- Mindre følgeskade. En komponent som byttes i tide, rekker ikke å skade utstyret rundt seg.
- Erfaring som blir værende. «Membranen ryker omtrent hvert halvår, bytt den i måned fem» er kunnskap som ofte sitter hos én person. Her blir den en regel som følges opp på alle anlegg.
Hvor mye er det verdt? Det amerikanske energidepartementets veileder for drift og vedlikehold anslår at et velfungerende prediktivt program sparer 8 til 12 prosent sammenlignet med forebyggende vedlikehold alene, og at anlegg som i stor grad driver reaktivt, kan spare 30 til 40 prosent eller mer (DOE). Veilederen er fra 2010, og tallene er generelle anslag. De sier ingenting om et bestemt anlegg.
Derfor starter vi med en tilbaketest (back-test). Analysen kjøres på historikken først, og varslene sammenlignes med det som faktisk skjedde. I demoen er metoden vist på simulerte data: Modellen er stilt inn på de første 60 av 120 dager og testet på de neste 60, mot dagens faste alarmgrenser.
- Median varslingstid før havari var 13,0 dager med AI-modellen og 2,8 dager med faste grenser.
- AI-modellen varslet 356 av 769 stanstimer. De faste grensene varslet 190.
- Treffraten var 44 prosent mot 40 prosent.
- AI-modellen ga flere feilvarsler, altså varsler som verken ble fulgt av havari innen 45 dager eller av et planlagt bytte: 261 mot 96.
- Bildet varierer med utstyrstypen. For elektromotorer fanget AI-modellen 78 prosent av havariene, mens de faste grensene ikke fanget noen. For filtre var det omvendt: Den faste grensen fanget 97 prosent, AI-modellen 57.
Poenget er at avveiningen blir synlig. Alarmnivået kan justeres: Et høyere nivå gir færre og sikrere varsler, men kortere varslingstid. Slike tall vil vi ha på bordet per maskintype, fra deres egen historikk, før noen bestemmer seg for utrulling.
Hva AI er god til når datamengdene blir store
Et menneske kan følge en håndfull kurver. Et anlegg har tusenvis, og en flåte har mange ganger det. Aker BP samler inn rundt én million tidsserier, og bare en liten andel av dem overvåkes, ifølge Cognite, som sammen med NVIDIA tar i bruk tidsseriemodeller for avviksdeteksjon hos selskapet (Cognite). Det er ikke vår leveranse, men det viser størrelsesordenen. Her er styrkene AI har på slike datamengder, slik de vises i Process Twin.
Sammenhenger mellom signaler
En fast grense ser på ett signal. Slitasjen på membranpumpa vises først i forholdet mellom flow, slagfrekvens, lufttrykk og luftforbruk. NVIDIAs Kumo-Anomaly vurderer slike sammenhenger over tid, uten at noen har merket dataene med «feil» og «normal» på forhånd.
Trender før grensen nås
Demoen har en egen visning for komponenter som ligger under dagens alarmgrenser, men der trenden alt peker mot havari. Hver av dem har en diagnose og en anbefalt kontroll. Det er forskjellen på en terskel på en skjerm og en analyse.
Sammenligning på tvers av anlegg
Den samme koblingen, pumpa eller motoren står på mange anlegg. Når alle måles mot flåtens friske nivå, blir avvik tydelige, og erfaring fra ett anlegg kan brukes på de andre. Demoen regner ut hvilke anlegg som kan lære av hverandre, og hvor felles reservedelslager og en felles vedlikeholdsmodell gir mening.
Mønstre i tid
I simuleringen ligger det en skjult historie: På ett anlegg stopper tappemaskinen oftere ved morgenoppstart. Analysen finner den. 22 av 42 stopp kom mellom klokka 06 og 09, nesten tre ganger så mange som forventet, og vanligste årsak var viskositet og temperatur i tappehodet. Hypotesen blir å forvarme tappehodet og standardisere oppstarten. Slike mønstre drukner i en vanlig alarmliste.
Prognoser og hva-om
Kumo-Forecast lager prognoser for den neste timen for flow, lagertemperatur og anleggets strømforbruk. Hva-om-visningen regner på endringer i vedlikeholdsintervall, turtall på mikseren og batchstørrelse, og på tiltak som rekkefølgen på batchene og forskjøvet oppstart, før noen endrer noe i anlegget.
Forklaringer på vanlig språk
En lokal språkmodell har lesetilgang til flåtedataene og svarer på spørsmål som «hvilke anlegg bør vi se på først, og hvorfor?». Den skriver også studier for ledelsen. Der lages tall og tabeller av kode, og teksten kontrolleres mot datagrunnlaget før rapporten lagres.
Og grensene
AI erstatter ikke mekanikeren.
Et avvik er en grunn til å undersøke, ikke en bekreftet feil, og et flagg kan like gjerne skyldes en helt normal batchovergang. Ferdigtrente modeller må kalibreres på normal drift for hver maskintype. I den første kjøringen vår slo ikke Kumo-prognosen en enkel sammenligning der siste måling bare gjentas, og det står åpent i demoen. Slike resultater er grunnen til at vi måler før vi lover noe.
Bygget på NVIDIAs modeller og verktøy
Skjld Labs er medlem av NVIDIA Inception, NVIDIAs program for selskaper som bygger med AI. Vi leverer prosjekter på NVIDIAs modeller, biblioteker og maskinvare, og Process Twin viser hvordan delene henger sammen. Dette kjører i demoen i dag:
- NVIDIA GB10. Demoen kjører på en Dell Pro Max med GB10, en liten maskin med NVIDIAs Grace Blackwell-brikke og 128 GB minne. Den tar datainnsamling, analyser, tidsseriemodeller og språkmodell samtidig.
- NVIDIA Kumo. Kumo er NVIDIAs familie av åpne modeller, biblioteker og verktøy for prediksjon på tabeller og tidsserier. Vi bruker Kumo-Anomaly til avviksdeteksjon og Kumo-Forecast til prognoser, på tre industrielle caser: membranpumpe, miksermotor med lagre og anleggets strømforbruk. Modellene kjører på GPU-en i maskinen, og ingen måledata sendes til NVIDIA eller andre.
- NVIDIA SimReady. 3D-arbeidscellen i demoen er bygget av sju av NVIDIAs SimReady-modeller i OpenUSD, konvertert for visning i nettleseren. Blant dem er pumpe, trykktank, IBC-container og transportbånd. Cellen viser hvordan utstyr kan få en plass og en identitet også når anlegget mangler CAD-modell.
- Lokal språkmodell. Assistenten og studiene bruker en åpen språkmodell som kjører på den samme GPU-en.
I et kundeprosjekt henter vi flere verktøy fra samme verktøykasse når behovet er der. Disse er foreslått som neste steg i Process Twin og må valideres i en pilot:
- Omniverse og OpenUSD for en full 3D-tvilling der levende måleverdier er koblet til hver komponent.
- NIM-mikrotjenester og NeMo Retriever for språkmodeller og søk i prosedyrer, vedlikeholdshistorikk og laboratorierapporter, med NeMo Guardrails som sperrer.
- RAPIDS cuDF og cuML når tusenvis av signaler og flere års historikk skal analyseres på GPU.
- Metropolis for kamerabasert kontroll ved tapping og pakking.
- Isaac Sim for simulering av intern logistikk før investering.
- cuOpt for produksjonsplanlegging som et optimeringsproblem.
I produksjon bytter vi utviklingsmaskinen med industriherdet maskinvare, for eksempel NVIDIA IGX Thor, Jetson eller en sertifisert server. IGX er laget for industrimiljøer og har støtte i opptil ti år (NVIDIA).
Fire måter å levere på
Hvor løsningen skal kjøre, avgjøres av dataene, nettverket og kravene deres. Vi leverer på fire måter, ofte i kombinasjon.
Onsite: i anlegget
Én NVIDIA-enhet per anlegg står bak brannmuren mellom OT og IT. Sensordata leses gjennom en godkjent gateway med OPC UA eller MQTT, og modellene kjører der dataene oppstår. Bare resultater forlater anlegget, for eksempel aggregerte nøkkeltall og utkast til arbeidsordrer. Koblingen mot styringssystemene er kun lesing. Tvillingen anbefaler, og den endrer aldri settpunkter i PLS eller DCS.
Lokalt: på egne servere i Sandefjord
Som standard kjører løsningene vi bygger, på egne servere i Sandefjord, med NVIDIA-maskinvare. Det passer for tilbaketester på historikk, studier og en felles flåtevisning når dataene kan forlate anlegget, men skal bli i Norge. Skjld Cloud, arbeidsrommet vårt for team og AI-agenter, driftes også på egne servere i Norge.
Cloud: når dere allerede har valgt plattform
Har dere en skyplattform fra før, eller trenger dere kapasitet til trening og simulering på tvers av mange anlegg, kan analyselaget kjøre der. Vi er Microsoft Solutions Partner og Google Cloud Partner.
Sammen med eksterne partnere og leverandører
Et vedlikeholdsprosjekt berører flere enn oss. Vi jobber sammen med dem dere allerede bruker: automasjonsleverandøren som kjenner PLS-ene, ERP-partneren som eier arbeidsordrene, og IT- og sikkerhetsmiljøet som skal godkjenne dataflyten. Der det passer best, står en ekstern partner eller leverandør for deler av leveransen, for eksempel maskinvare, nettverk eller drift. Som medlem av NVIDIA Inception har vi tilgang til NVIDIAs teknologi, opplæring og eksperter når et prosjekt trenger det.
Uansett modell gjelder de samme reglene: lesetilgang som utgangspunkt, minste nødvendige rettigheter, godkjenning fra en navngitt person for alt som skrives tilbake, og en logg over hvem som godkjente hva.
Passer inn i systemene dere har
En tvilling er nyttig først når den snakker med resten av virksomheten. Process Twin er laget for tre typer koblinger:
- Bygningsmodellen (IFC/BIM). Modellen gir hver maskin en plass og en fast ID. Pumpa i tegningen, sensoren på pumpa og pumpa i ERP-systemet blir én og samme.
- ERP og vedlikeholdssystem. Tvillingen leser lager og utstyrshistorikk og lager utkast til arbeidsordre og delebestilling. En person godkjenner før noe sendes.
- CRM. Når en linje trenger vedlikehold, viser tvillingen hvilke kundeordrer som avhenger av den, slik at stansen kan planlegges eller kunden varsles i tide.
I demoen er ERP-koblingen en etterligning, IFC-koblingen et illustrert eksempel og CRM ikke koblet til. I en leveranse settes koblingene opp og valideres for hver kunde, først mot kopier og testmiljøer.
Fra demo til pilot
Vi anbefaler å starte smalt: ett anlegg, én maskinfamilie og én feiltype. Vi begynner med feilmekanismen, sammen med maskiningeniøren vår og vedlikeholdsfolkene deres, og velger signaler etterpå.
- Teknisk gjennomgang. Utstyrsliste, arbeidsordrehistorikk og signalliste. Sammen velger vi anlegg, maskinfamilie og feiltype.
- Tilbaketest og enhet i anlegget. Analysen kjøres på historikken først. Parallelt installeres én NVIDIA-enhet bak OT-gatewayen, gjennomgått av IT, OT og sikkerhet.
- Måleperiode og resultatark. Varsler, teknikerfunn og arbeidsordrer logges på de samme maskinene. Dere får et før-og-etter-ark med egne tall og en utrullingsplan sortert etter hvor modne dataene er på hvert anlegg.
Ingen gevinst påstås før den er målt.
Holder ikke dataene til en prognose for restlevetid, får dere en tilstandsanalyse og en plan for datainnsamling i stedet, og vi sier det rett ut.
For å komme i gang trenger vi fire ting: en utstyrsliste, arbeidsordrehistorikk fra ERP-systemet, en signalliste og en kontaktperson for IT og OT.
Hva demoen ikke er
Process Twin er en demonstrator. Anleggsdataene er simulerte, og ERP, arbeidsordrer og innkjøp er etterligninger. Ingen ekte ordre sendes, og ingen maskiner styres. 3D-scenen er en illustrasjon, ikke en Omniverse-tvilling. Gevinsttallene i demoen er regnet ut fra simuleringen og oppgitte forutsetninger for å vise metoden. Prediksjoner må valideres på ekte data, og mennesker godkjenner arbeidsordrer og innkjøp.
Test selv
Demoen ligger åpent på pt.skjld.cloud. Start med pumpescenariet og følg de ti stegene, eller gå rett til det som betyr mest for dere. Grensesnittet er på engelsk.
Vil dere se hva dette betyr for egne maskiner? Book en gratis samtale på tretti minutter, eller les mer om lokal og norsk AI.
Les også
- Lokal prediktiv analyse: Slik kan SMB-er utnytte AI uten skyavhengighet og høye lisenskostnader
- Slik styrer lokal AI ventilasjonen hos Hudlege Andersen
- Hvor havner dataene når dere bruker AI?
Kilder
- Skjld Labs: Process Twin, demonstrator med simulerte data. Tallene fra demoen er lest av 17. november 2026.
- NVIDIA: Kumo, oversikt og Kumo-TS på GitHub
- NVIDIA: SimReady-modeller
- NVIDIA: IGX
- Dell: Dell Pro Max med GB10
- U.S. Department of Energy, FEMP: Operations & Maintenance Best Practices, Release 3.0, august 2010, kapittel 5
- Cognite: pressemelding om NV-Tesseract hos Aker BP, 23. mars 2026
- Hovedbildet er en AI-generert illustrasjon, ikke et foto fra et anlegg.
Jon Gottfred Andersen er styreleder og medgründer i Skjld Labs og spesialist i hud- og veneriske sykdommer, med egen hudlegeklinikk i Sandefjord. Mer om Jon