
Fra lineære prompts til grafer: en praktisk innføring i graph engineering
«Graph engineering» er sommerens store samtaleemne i AI-feltet, men bak buzzordet ligger en enkel og nyttig idé: arbeidsflyter består av oppgaver og avhengigheter, og de fleste lar AI-en vente på ting den ikke trenger å vente på. Her forklarer vi hva graf-tankegangen faktisk innebærer, hvordan du finner falske avhengigheter i egne prosesser, og hvorfor kontrollnoder og etterprøvbarhet er minst like viktig som fart for norske virksomheter.
 Jon Gottfred AndersenStyreleder og hudlege
Med jevne mellomrom dukker det opp et begrep som hele AI-feltet snakker om samtidig. Denne sommeren er det «graph engineering». En mye delt artikkel publisert på X av @Mahaximus_, med nærmere en halv million visninger, satte ord på skiftet: der vi tidligere bygde AI-arbeidsflyter som lange kjeder av instruksjoner, begynner stadig flere å tegne dem som grafer.
Som med de fleste buzzord er det fristende å avfeie det. Men bak hypen ligger en idé som er både enkel og svært anvendelig, også for norske virksomheter som aldri kommer til å kalle seg «AI-selskaper». I denne artikkelen forklarer vi hva graf-tankegangen faktisk innebærer, hvordan du finner flaskehalsene i egne arbeidsflyter, og hvorfor dette handler minst like mye om kvalitet og kontroll som om fart.
Hva en graf faktisk er
Glem søylediagrammer og kurver. En graf i denne sammenhengen er noe langt enklere: et kart over hvilke oppgaver som skal gjøres, og hva hver oppgave er avhengig av.
Kartet består av to byggeklosser. En node er en avgrenset arbeidsoppgave: én agent, én jobb, én ting inn og én ting ut. Jo mindre og tydeligere jobben er definert, jo mer nyttig er noden. En kant er en avhengighet mellom to noder, og den finnes bare når den ene oppgaven faktisk trenger resultatet fra den andre. Ikke «disse skjer etter hverandre», men «denne bruker det den forrige produserte».
Det er hele modellen. Resten av graph engineering er å anvende disse to ideene konsekvent, i stort og smått.
Arbeidsflyten din er allerede en graf
Her er det de fleste overser: du driver allerede med dette, bare uten å tenke over det. Når du skriver en prompt som «undersøk temaet, oppsummer funnene, og skriv et utkast basert på oppsummeringen», har du laget en graf. En kjede, der hvert steg venter på det forrige.
Kjeden er den enkleste grafen som finnes, og den fungerer. Men enkel er ikke det samme som effektiv. Kjeden er treg, fordi alt står i kø. Og den er skjør, fordi ett dårlig mellomresultat stopper alt som kommer etter. Det første grepet i graph engineering er derfor ikke å lære noe nytt. Det er å se på det du allerede har og spørre: må hvert steg egentlig vente på det forrige?
Testen som avslører falske avhengigheter
Svaret finner du med en øvelse som tar under fem minutter, og som du kan gjøre på en tavle:
- Skriv opp hvert steg i arbeidsflyten som en boks.
- Tegn piler mellom stegene slik de kjøres i dag.
- Spør for hver pil: flyter det faktisk data fra det ene steget inn i det andre?
- Behold pilene der svaret er ja. Stryk resten. Det er falske avhengigheter.
- Alt som står igjen uten innkommende pil, kan starte umiddelbart og kjøres parallelt.
Ta en månedsrapport som eksempel. Tallene skal hentes fra regnskapssystemet, prosjektstatus fra prosjektverktøyet og kundeaktivitet fra CRM-en, før alt sammenstilles til én rapport. I praksis gjøres dette gjerne i rekkefølge, men ingen av de tre innhentingene trenger hverandre. Kjøres de samtidig, er ventetiden lik den tregeste av dem, ikke summen av alle tre. De fleste som tegner opp en egen arbeidsflyt på denne måten, finner to til tre falske avhengigheter i første forsøk. Hver av dem er ventetid virksomheten gir bort gratis.
Diamanten: mønsteret som går igjen
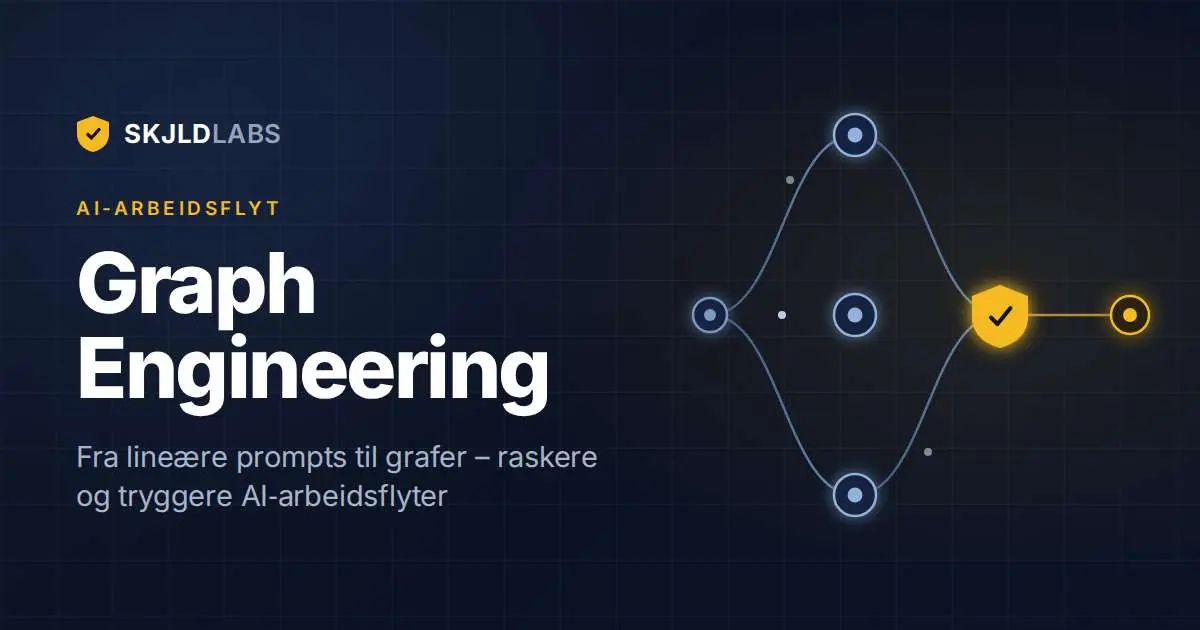
Når du begynner å fjerne falske avhengigheter, dukker ett mønster opp oftere enn alle andre. Én node vifter ut i flere parallelle noder, som alle samles i en siste node som setter resultatene sammen. Tegner du det opp, ser det ut som en diamant.
Månedsrapporten over er en diamant: innhentingen skjer parallelt, sammenstillingen er samlepunktet. Det samme mønsteret finner du i research, anbudsarbeid, kodegjennomgang og markedsanalyser, overalt der formen er «hent fra flere kilder, kombiner til slutt». Mønsteret har to regler: de parallelle nodene må være reelt uavhengige av hverandre, og samlenoden må faktisk trenge alle resultatene. Får du begge på plass, er diamanten den raskeste formen en arbeidsflyt kan ha.
Der grafer feiler i det stille
Parallellitet har en bakside, og den er lett å overse. Når tre noder kjører samtidig og én av dem leverer søppel, som en hallusinasjon, et tomt resultat eller en feillest fil, flyter feilen rett inn i sammenstillingen sammen med de gode resultatene. Samlenoden vet ikke at én av kildene er dårlig. Den kombinerer alt og leverer et selvsikkert svar bygget på sviktende grunnlag. Strukturen som gjorde deg rask, fjernet samtidig de naturlige sjekkpunktene der du ville oppdaget problemet.
Løsningen er en kontrollnode: en node som sitter mellom det parallelle laget og samlepunktet, og som har én eneste jobb: å vurdere om hvert resultat er brukbart før det slippes videre. Tomme svar, motstridende funn, resultater på siden av oppgaven og formatfeil skal flagges, kjøres på nytt eller forkastes før de forgifter neste steg.
For oss i Skjld Labs er dette det viktigste punktet i hele modellen. En graf uten kontrollnoder er en graf som antar at alt oppstrøms fungerte, og den antagelsen svikter oftere enn man tror. Kvalitetssikring må være en del av arkitekturen, ikke noe et menneske gjør manuelt i etterkant når det er tid til det.
Statisk eller dynamisk, og hvorfor kontroll trumfer fleksibilitet
En statisk graf er definert på forhånd: du vet nøyaktig hvilke noder som kjører, i hvilken rekkefølge, og hvorfor. Den er rask, forutsigbar og, ikke minst, etterprøvbar. En dynamisk graf bygger seg selv underveis: en node fullfører, ser på resultatet og bestemmer hva som skal skje videre. Det er kraftig når omfanget av jobben først blir tydelig mens arbeidet pågår, men vanskeligere å feilsøke og revidere, fordi strukturen som faktisk kjørte, ikke er den du tegnet.
For norske virksomheter er etterprøvbarhet sjelden valgfritt. Skal AI-arbeidsflyter brukes i prosesser som berører kunder, ansatte eller økonomi, må du kunne dokumentere hva som kjørte og hvorfor, både av hensyn til internkontroll og til regelverk som GDPR og EUs AI-forordning. Rådet vårt er derfor enkelt: start alltid statisk. Gå bare over til dynamiske grafer når du treffer en vegg den statiske grafen ikke kan løse, og aldri i prosesser som krever full revisjonssporbarhet. De fleste arbeidsflyter som «føles» dynamiske, trenger i realiteten bare en bedre designet statisk graf.
Hva dette betyr for din virksomhet
Det fine med graf-tankegangen er at du ikke trenger å bygge noe som helst for å ha nytte av den. Bare det å tegne opp en eksisterende prosess og stryke de falske avhengighetene gir ofte gevinst samme uke, uavhengig av hvilke verktøy du bruker.
Samtidig har verktøyene modnet raskt. Moderne agentplattformer lar deg beskrive noder og avhengigheter direkte, og finner selv ut hva som kan kjøres parallelt. Det gjelder også Claude, som den omtalte artikkelen tar utgangspunkt i. Du beskriver grafen. Plattformen håndterer rekkefølgen. Det gjør terskelen for å gå fra tavleskisse til kjørende arbeidsflyt lavere enn noen gang.
I Skjld Labs bruker vi denne tilnærmingen når vi bygger AI-løsninger for kundene våre. Konkret hjelper vi virksomheter med å:
- kartlegge eksisterende arbeidsflyter og identifisere stegene som faktisk kan parallelliseres
- designe grafer med kontrollnoder, slik at fart aldri går på bekostning av kvalitet
- velge riktig balanse mellom statiske og dynamiske grafer ut fra krav til styring og sporbarhet
- implementere løsningene sikkert, med tilgangsstyring og logging som tåler revisjon
Vil du se hva dette betyr i praksis?
Har du en arbeidsflyt du mistenker er full av falske avhengigheter? Ta kontakt for en uforpliktende prat, så tegner vi den opp sammen, og viser deg hvor tiden faktisk forsvinner.