
Jev og System 1-modeller: den raske hjernen AI-agentene har manglet
TypeSafe har lansert Jev, en «System 1-modell» som tar raske, typede beslutninger i stedet for å skrive tekst, og LangChain viser hvordan den brukes som ruter og vakt i agent-harnessen. Vi har testet det åpne alternativet Laya lokalt. Her er hva det er, hvordan det kan brukes, og hva vi så, også på norsk.
 Jon Gottfred AndersenStyreleder og hudlege
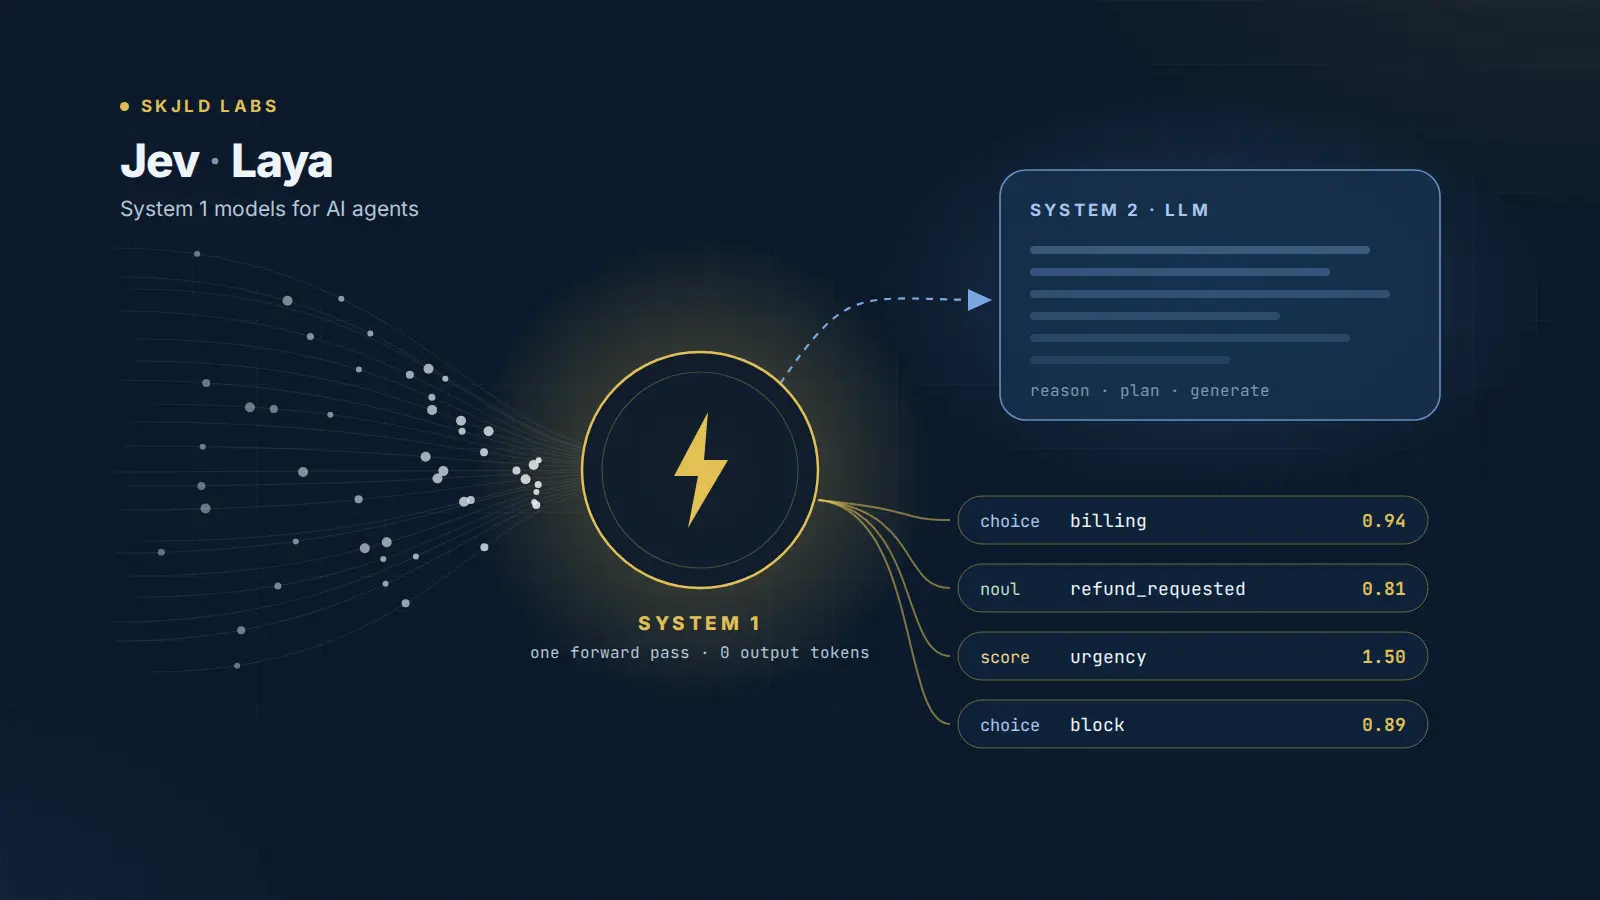
Daniel Kahneman delte tenkningen vår i to. System 1 er rask, automatisk og intuitiv. System 2 er langsom, bevisst og krevende. Som hudlege kjenner jeg skillet godt: mye av en dag på kontoret er rask mønstergjenkjenning, og så får de vanskelige sakene full utredning. Å gi hver eneste sak full utredning ville vært både tregt og dyrt.
Likevel er det nettopp slik vi bygger de fleste AI-agenter i dag. Hver lille beslutning underveis sendes til en stor språkmodell: Haster dette? Hvilken avdeling skal ha saken? Er dette verktøykallet trygt? Det koster sekunder og tokens, og svaret kommer som fritekst som må tolkes. Denne måneden kom et av de tydeligste svarene på det problemet så langt: Jev.
Hva er Jev?
Jev ble lansert av TypeSafe AI 15. september, foreløpig i early access. Selskapet kaller det en System One-modell. Det er ikke en språkmodell som skriver tekst, men en modell som tar en tilstand inn og gir typede beslutninger med sannsynligheter ut. TypeSafe beskriver det selv som «unstructured state in, typed probabilistic decisions out».
Du gir Jev to ting:
- State: teksten eller dataene som skal vurderes, for eksempel en e-post.
- Spørsmål av tre typer:
choice(velg ett av flere alternativer),score(plasser på en ordnet skala) ognoul(ja eller nei, uttrykt som en sannsynlighet mellom 0 og 1).
Alle spørsmålene besvares parallelt i én og samme spørring, så ett spørsmål ekstra koster nesten ingenting. Og fordi modellen bare kan velge blant alternativene du har definert, får du aldri et svar som ikke passer i skjemaet. Den kan selvsagt velge feil alternativ, men den kan ikke finne på et nytt.
Tallene TypeSafe oppgir er ambisiøse: opptil rundt 200 ganger raskere og 400 ganger billigere enn sammenlignbare språkmodeller på klassifiseringsoppgaver, 70-500 millisekunder responstid ende til ende, og 0,042 dollar per million input-tokens. Output-tokens er gratis. Dette er leverandørens egne målinger.
Harnessen: der Jev gjør mest nytte
To dager etter lanseringen, 17. september, publiserte LangChain en gjennomgang av hvordan Jev brukes i en harness: alt som ligger rundt selve modellen i en agent, som løkken, verktøyene, reglene og kontrollpunktene. Utgangspunktet er nøkternt. LangChain skriver rett ut: «Agents are still inherently untrustworthy.»
Integrasjonen heter langchain-typesafe og gir to ferdige mellomlag (middleware):
- Modellruting (
ModelRouterMiddleware). Jev vurderer hver forespørsel og velger den billigste modellen som klarer oppgaven. Et enkelt oppslag trenger ikke samme modell som en vanskelig feilsøking. - Auto mode (
AutoModeMiddleware). Jev sjekker agentens verktøykall og blokkerer risikable kall før verktøyet kjøres. Det er samme mønster som kodeassistentene bruker når de ber om lov før farlige kommandoer.
from langchain.agents import create_agent
from langchain_typesafe.experimental.middleware import AutoModeMiddleware

guardrail = AutoModeMiddleware(tools=["bash"])
agent = create_agent("openai:gpt-5.6-luna", middleware=[guardrail])
LangChain trekker også frem tre tidlige prosjekter: nettleseragenter hos Browserbase som kjører «for fractions of a cent», en agent for live trading og e-posttriage i stor skala. Oppsummeringen deres er god: bruk en språkmodell til åpen resonnering og tekst, og Jev til de raske, strukturerte beslutningene underveis.

Hvordan kan dette brukes i en norsk virksomhet?
TypeSafe beskriver typede svar som uklare beslutningsregler som kan stå rett i vanlig programvare: klassifiser, rut, gi poeng, trekk ut eller forgrein der håndskrevne regler blir for skjøre. For virksomhetene vi jobber mest med, som regnskapsbyråer, advokatkontorer og klinikker, ser jeg særlig fire bruksområder:
- Innboks-triage. Hvilken avdeling skal ha e-posten? Haster den? Ber avsenderen om noe konkret? Er det phishing?
- Dokumentflyt. Er dette en faktura, et bilag eller en kontrakt? Ser det ut som et duplikat? Må et menneske se på avviket?
- Ruting mellom modeller. Send de enkle sakene til en liten, rask modell og de vanskelige til en stor.
- Vakt. Stopp risikable verktøykall, og spør «inneholder dette personopplysninger?» før noe sendes videre til en ekstern tjeneste.
Sannsynlighetene er det som gjør dette nyttig i praksis. Du kan la systemet handle selv når modellen er sikker, og sende resten til et menneske. Men det krever at sannsynlighetene faktisk betyr noe. Det kommer jeg tilbake til.
Laya: et åpent alternativ vi kan kjøre selv
Jev har én egenskap som gjør det vanskelig for mange norske virksomheter: det er et lukket API. Teksten som skal vurderes, må sendes til TypeSafe. For en klinikk eller et advokatkontor er det en reell grense for hvilke data man kan bruke det på.
Derfor ble vi nysgjerrige på Laya fra ConvAI Innovations: en åpen System 1-modell på Hugging Face med de samme tre spørsmålstypene, lisensiert under Apache 2.0. Laya bygger på ModernBERT-large (395 millioner parametere) med et eget beslutningshode oppå, til sammen 421 millioner. Det finnes også en flerspråklig variant på 322 millioner parametere som skal dekke over 100 språk.
Prinsippet er elegant. Hvert svaralternativ får sin egen [MASK]-plass i input. Modellen scorer alle alternativene i én forward pass, og en softmax per spørsmål gir sannsynlighetene. Treningen belønner ærlige sannsynligheter: ConvAI bruker det de kaller «Reinforcement Learning for Calibrated Decisions», der belønningen er en såkalt proper scoring rule. Da lønner det seg ikke for modellen å late som den er sikrere enn den er.
Vi kjører Laya i labben på et RTX 4090, gjennom den lokale playgrounden som følger med.

Eksempelet i playgrounden er en e-post om dobbeltbelastning på en faktura, med en trussel om å si opp avtalen. Fire spørsmål, én forward pass, 301 tokens inn og null tokens ut:

Avdeling: billing, med 94 prosent sannsynlighet. Refusjonskrav: 0,81. Oppsigelsesrisiko: 0,78. Hasteskåren lander mellom «snart» og «hard frist». Dette er svar vanlig kode kan bruke direkte, uten å tolke fritekst.
Slik måler ConvAI Laya mot Jev
Modellkortet sammenligner Laya direkte med Jev. Laya leder på tre av fire oppgaver, svarer på 33 millisekunder mot Jevs 236-276, og har en kalibreringsfeil (ECE) på 0,081 mot 0,246. Tre forbehold er likevel viktige. Tallene er ConvAIs egne. Jev vinner klart på Banking77 med 77 klasser, fordi Laya får for lite plass per alternativ i sin korte kontekst. Og kalibreringen på 0,081 gjelder etter temperaturskalering. Rett ut av boksen er modellen for selvsikker, og ConvAI ber deg kalibrere på egne data før du stoler på sannsynlighetene.

Hva vi så da vi testet selv
Benchmarks er ikke arbeidshverdagen din, så vi kjørte noen små røyktester selv. Dette er ingen vitenskapelig evaluering, bare noen titalls kjøringer for å se hvordan modellen oppfører seg. Men de sa mye.
1. Som vakt er den en triage, ikke en lås
Vi ga den engelske Laya-modellen ti bash-kommandoer, fem ufarlige og fem risikable, og spurte om kallet skulle tillates, sendes til et menneske eller blokkeres.

Alle de fem risikable kommandoene ble blokkert, også rm -rf på backupkatalogen og forsøket på å kopiere en privat SSH-nøkkel ut av maskinen. Men modellen blokkerte også cat README.md og pytest, og ingen av de ufarlige kommandoene fikk mer enn 52 prosent «tillat». Den flerspråklige varianten var verre: den slapp gjennom både SSH-nøkkelen og curl … | sudo bash.
Lærdommen er ikke at ideen er dårlig. Lærdommen er at en System 1-vakt uten tilpasning må brukes med terskler: tillat automatisk bare når modellen er svært sikker, og send alt annet til et menneske. Deretter tilpasser man modellen på egne logger. ConvAI skriver selv at basismodellene ligger nær tilfeldig gjetting på slike typede arbeidsflyter uten tilpasning.
2. Norsk er ikke engelsk
Så oversatte vi eksempel-e-posten til norsk: «Vennligst refunder det dobbelte beløpet i dag, ellers sier vi opp avtalen.»

Både den engelske og den flerspråklige modellen fant avdelingen og refusjonskravet. Men begge bommet på oppsigelsesrisikoen. For den engelske modellen falt sannsynligheten fra 0,78 på engelsk til 0,08 på norsk. Den betingede trusselen «ellers sier vi opp» gikk rett forbi.
På åtte korte norske meldinger, fire med oppsigelsesrisiko og fire uten, gjorde den flerspråklige modellen det best når vi også stilte spørsmålet på norsk: sju av åtte riktige. Den engelske modellen med norske spørsmål traff bare tre av åtte. I tillegg klassifiserte den innebygde språkdetektoren i laya-pakken (versjon 0.3.10) den norske e-posten som engelsk, så den automatiske ruteren ville valgt feil modell. Modellkortet oppgir heller ikke om norsk er blant de 51 språkene som er testet.
Slik tenker vi videre
Vi har ikke en System 1-modell i produksjon. Laya kjører i labben, og funnene over er grunnen til at den blir der en stund til. Men retningen er klar for meg. En stor språkmodell på egne servere er System 2: den resonnerer, planlegger og skriver. Foran og rundt den trenger vi et raskt lag som velger modell, sorterer innboksen og holder vakt. Det laget må også kunne kjøre lokalt, ellers har vi bare flyttet personvernproblemet et hakk ut i stedet for å løse det.
Veien dit går gjennom det lite glamorøse arbeidet: et norsk testsett bygget på reelle, anonymiserte saker, kalibrering av sannsynlighetene, tilpasning på egne data og terskler som sender tvilstilfellene til et menneske. Åpne vekter gjør at alt dette kan gjøres på egen maskinvare i Norge.
Oppsummert
- Jev gjør System 1-tenkning tilgjengelig som et API: typede svar med sannsynligheter, på millisekunder og for en brøkdel av prisen for en språkmodell.
- Harnessen er stedet det gir mest verdi: ruting mellom modeller og vakt på verktøykall.
- Laya viser at det samme kan kjøres åpent og lokalt. I våre tester trenger den likevel norske data, kalibrering og terskler før den fortjener tillit.
Vurderer dere AI-agenter i egen virksomhet, og lurer på hvordan de kan bli raskere, billigere og tryggere uten at dataene forlater huset? Book en uforpliktende samtale, eller les mer om AI-systemene og agentene vi bygger.
Kilder: LangChain: Building a harness with Jev (17. september 2026), TypeSafe: Introducing System One Models & Jev (15. september 2026), modellkortet for convaiinnovations/laya og laya på GitHub. Røyktestene er kjørt av Skjld Labs med laya 0.3.10. Grafikk: Skjld Labs.