
Fra labben: styrken i KI for proteindesign og medisin
Fra proteinform til cellebiologi: faktiske strukturmodeller, en lokal Geneformer-pilot og interaktive 3D-visninger viser både mulighetene og begrensningene.
 Jon Gottfred AndersenStyreleder og hudlege
Fra labben · mulighetsstudie og teknologidemonstrasjon. Egne beregninger, publiserte referanser og syntetiske eksempler er merket hver for seg. Vi har ikke gjennomført biologiske forsøk eller pasientstudier.
Den store muligheten med KI i proteinarbeid er at en biologisk idé kan bli til et konkret molekylforslag som andre kan undersøke. Vi kan beskrive en målflate, generere sekvenser, beregne strukturer og utfordre kontaktmønsteret med andre modeller. Her forklarer vi styrken i denne arbeidsformen, hva vi faktisk har gjort i Skjld Labs, og hvorfor veien fra struktur til medisin fortsatt krever flere typer bevis.
Nytt i labben: en modell for cellenes tilstand
Proteinmodeller og cellemodeller belyser forskjellige deler av et medisinsk problem. RFD4-Proteina kan foreslå en proteinform mot en valgt målflate. Geneformer behandler rangert genuttrykk fra enkeltceller og lager representasjoner av deres biologiske sammenheng. Det åpner for et tidligere spørsmål i prosessen: hvilke celletyper, tilstander og signalmiljøer bør et proteinprosjekt egentlig rette seg mot?
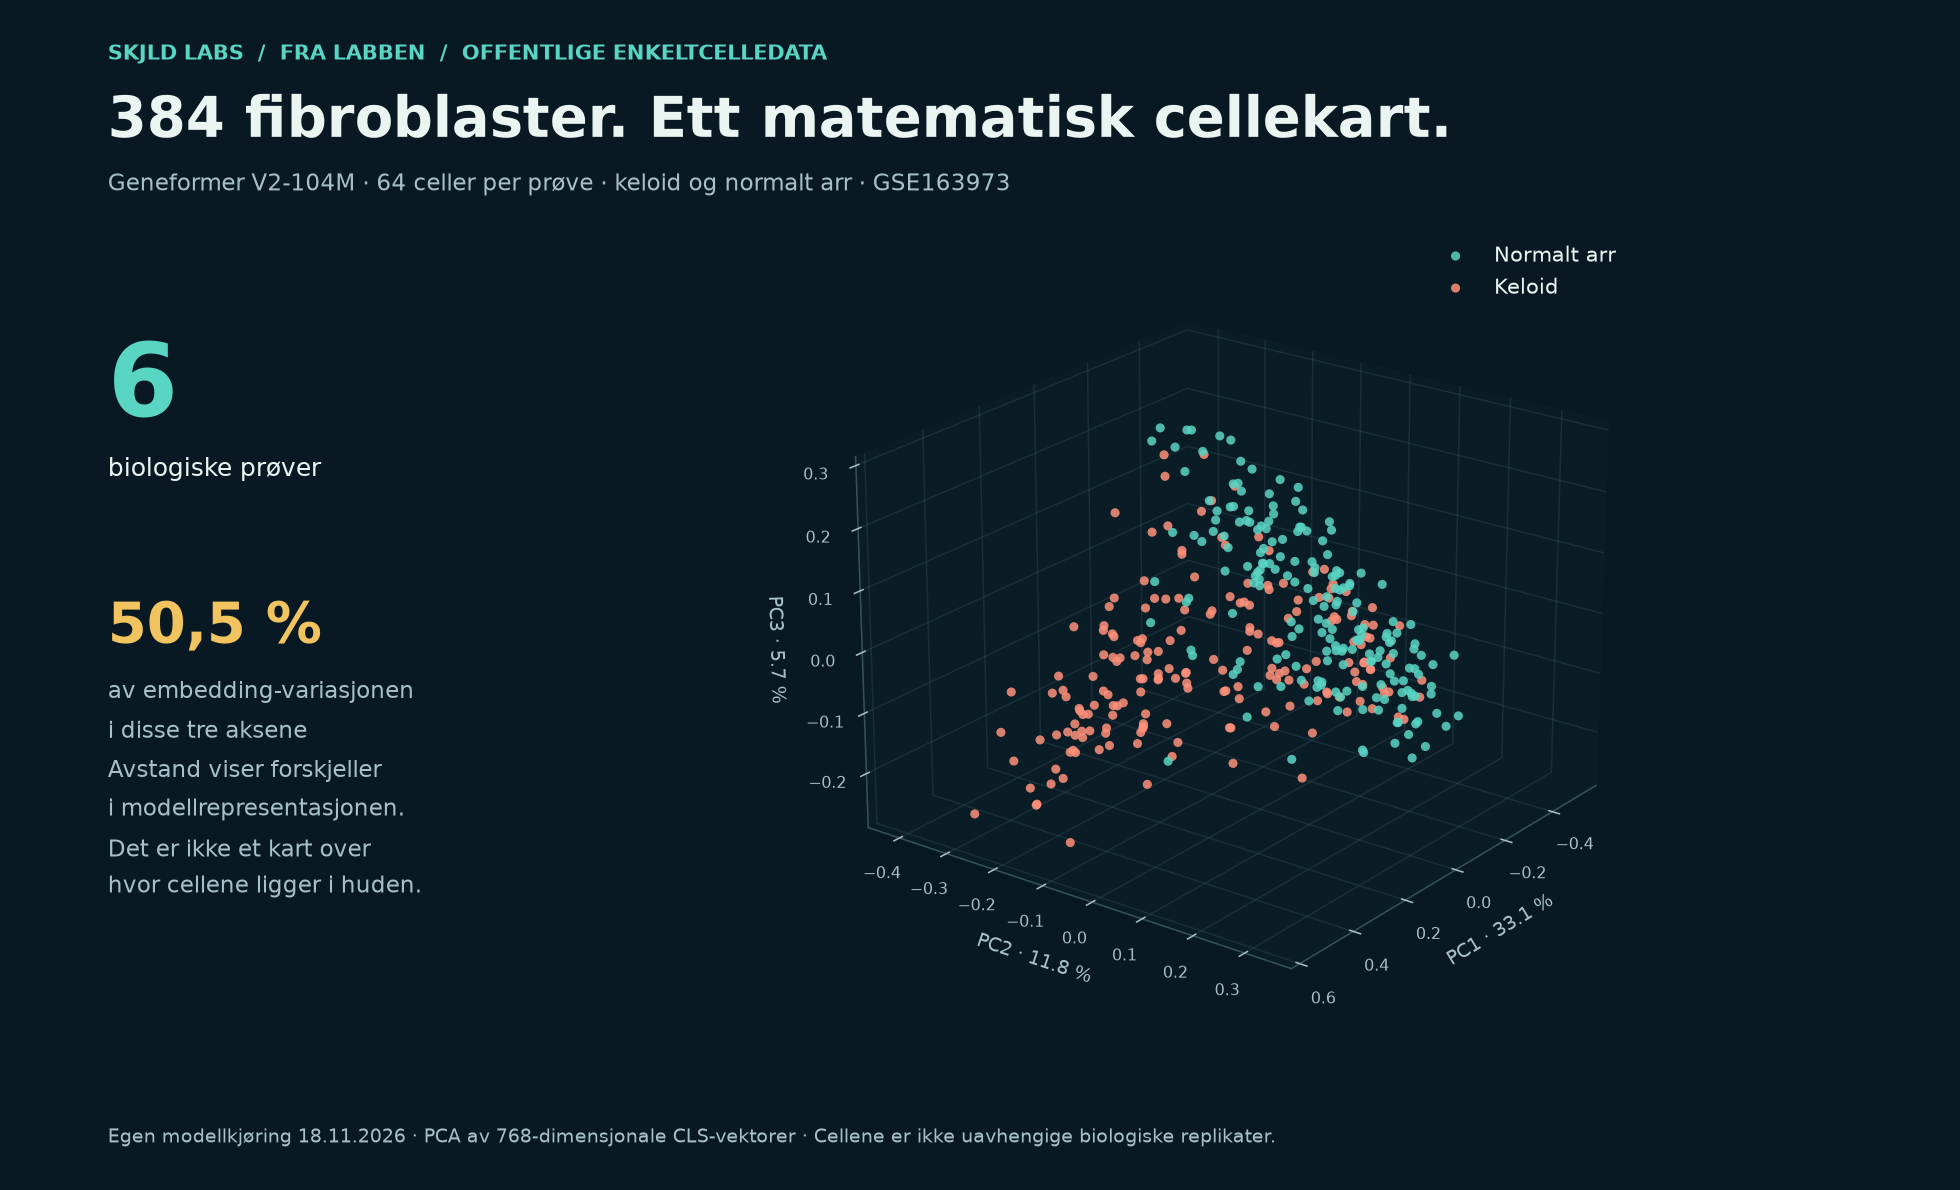
Vi har nå testet Geneformer V2-104M lokalt på RTX 4090. Utgangspunktet var offentlige keloiddata fra Deng og medarbeidere, tilgjengelig som GSE163973. Av 12 177 annoterte fibroblaster valgte vi tilfeldig 64 fra hver av seks prøver, totalt 384. Tre prøver kom fra keloider og tre fra normale arr.
Åpne det interaktive 3D-cellekartet →
Hvert punkt i kartet representerer en celles 768-dimensjonale modellvektor, projisert til tre matematiske akser. Her kan leseren fargelegge etter sykdomsgruppe, biologisk prøve eller målt POSTN-genuttrykk. Det er en utforskbar visning av data og modellrepresentasjoner. Det er ikke et romlig kart over huden eller en simulering av en kur.
En faktisk kjøring — og et resultat som begrenser ambisjonen
Modellvarianten og ordbøkene er låst til en dokumentert revisjon. Vi brukte maksimalt 4096 tokener per celle, CLS-vektoren fra nest siste lag og float32 uten kvantisering. Innlasting, embeddingene og én kontrollberegning tok omtrent 26 sekunder i den registrerte kjøringen. Nedlasting, databehandling og evaluering kommer i tillegg. Høyeste PyTorch-allokering var omtrent 1,02 GiB; dette er ikke hele maskinens GPU-forbruk.
Vi undersøkte deretter om representasjonene kunne skille keloid fra normalt arr i en prøve klassifikatoren ikke hadde sett. Én hel prøve ble holdt utenfor hver gang, og alle lærte transformasjoner ble tilpasset de fem andre. Sammenligningen brukte enkle genuttrykksdata, PCA og samme type klassifikator. Dette skiller hva som er en imponerende visualisering fra hva som har vist nytte i akkurat denne oppgaven.
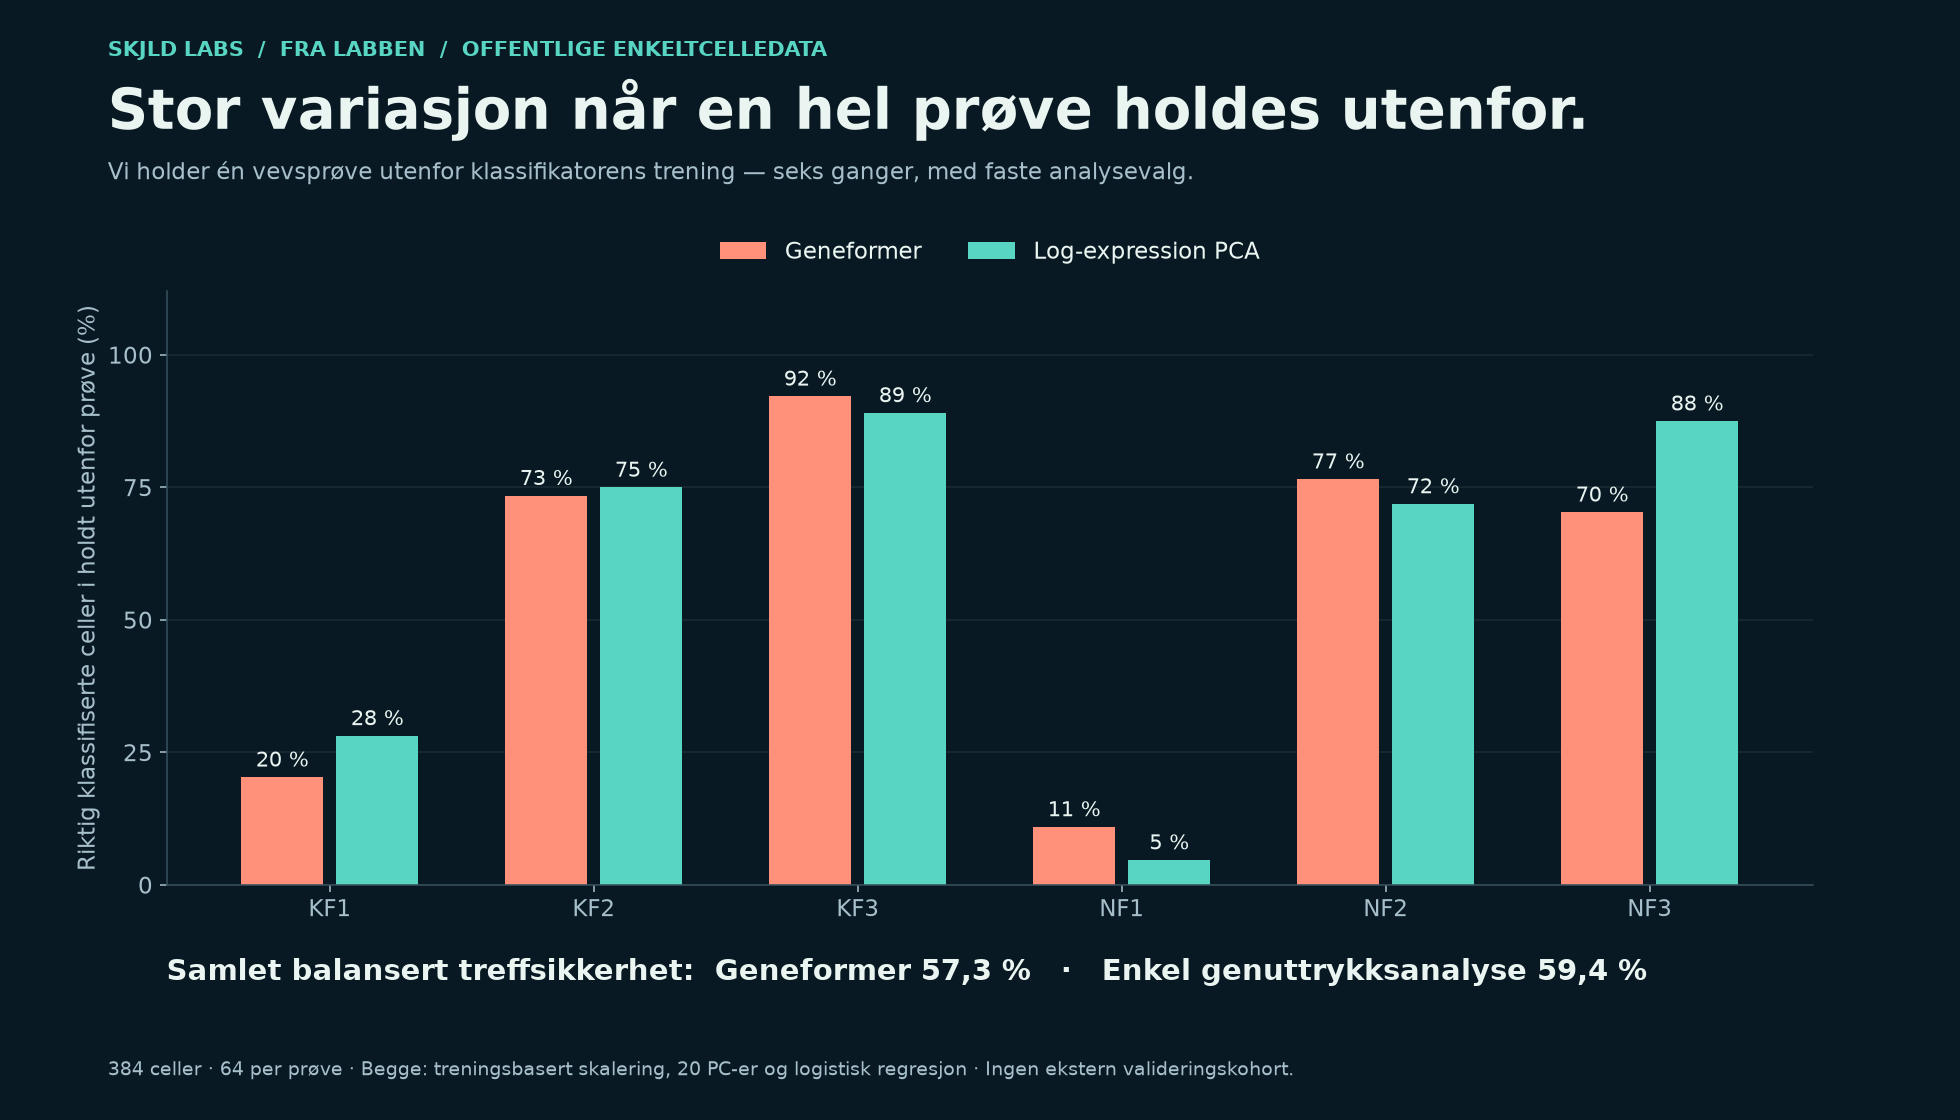
Geneformer ga 57,3 % balansert treffsikkerhet, mot 59,4 % for sammenligningen. Det tilsvarer 220 mot 228 riktige celleetiketter av 384, med stor variasjon mellom prøver. Vi har seks biologiske prøver, ingen separat testkohort og uavklart overlapp med modellens forhåndstrening. Resultatet dokumenterer at oppsettet kjører, men ikke at det gir bedre målvalg eller bedre medisin.
Dermed er digitale genperturbasjoner fortsatt et mulig senere trinn. Vi har ikke kjørt dem eller brukt dem til å rangere kandidater. Den publiserte Geneformer-protokollen gir en ramme for å undersøke slike anvendelser, men vår egen pilot må først få bedre biologisk avgrensning og validering. Et modellert skifte i en cellevektor er heller ikke et mål på effekten av en ekstracellulær binder.
Les full metode og resultater · Last ned kode, tall og modellrepresentasjoner (ZIP, 6,3 MB) · Maskinlesbar kjøringsrapport.
Se proteinforslaget fra flere modellperspektiver
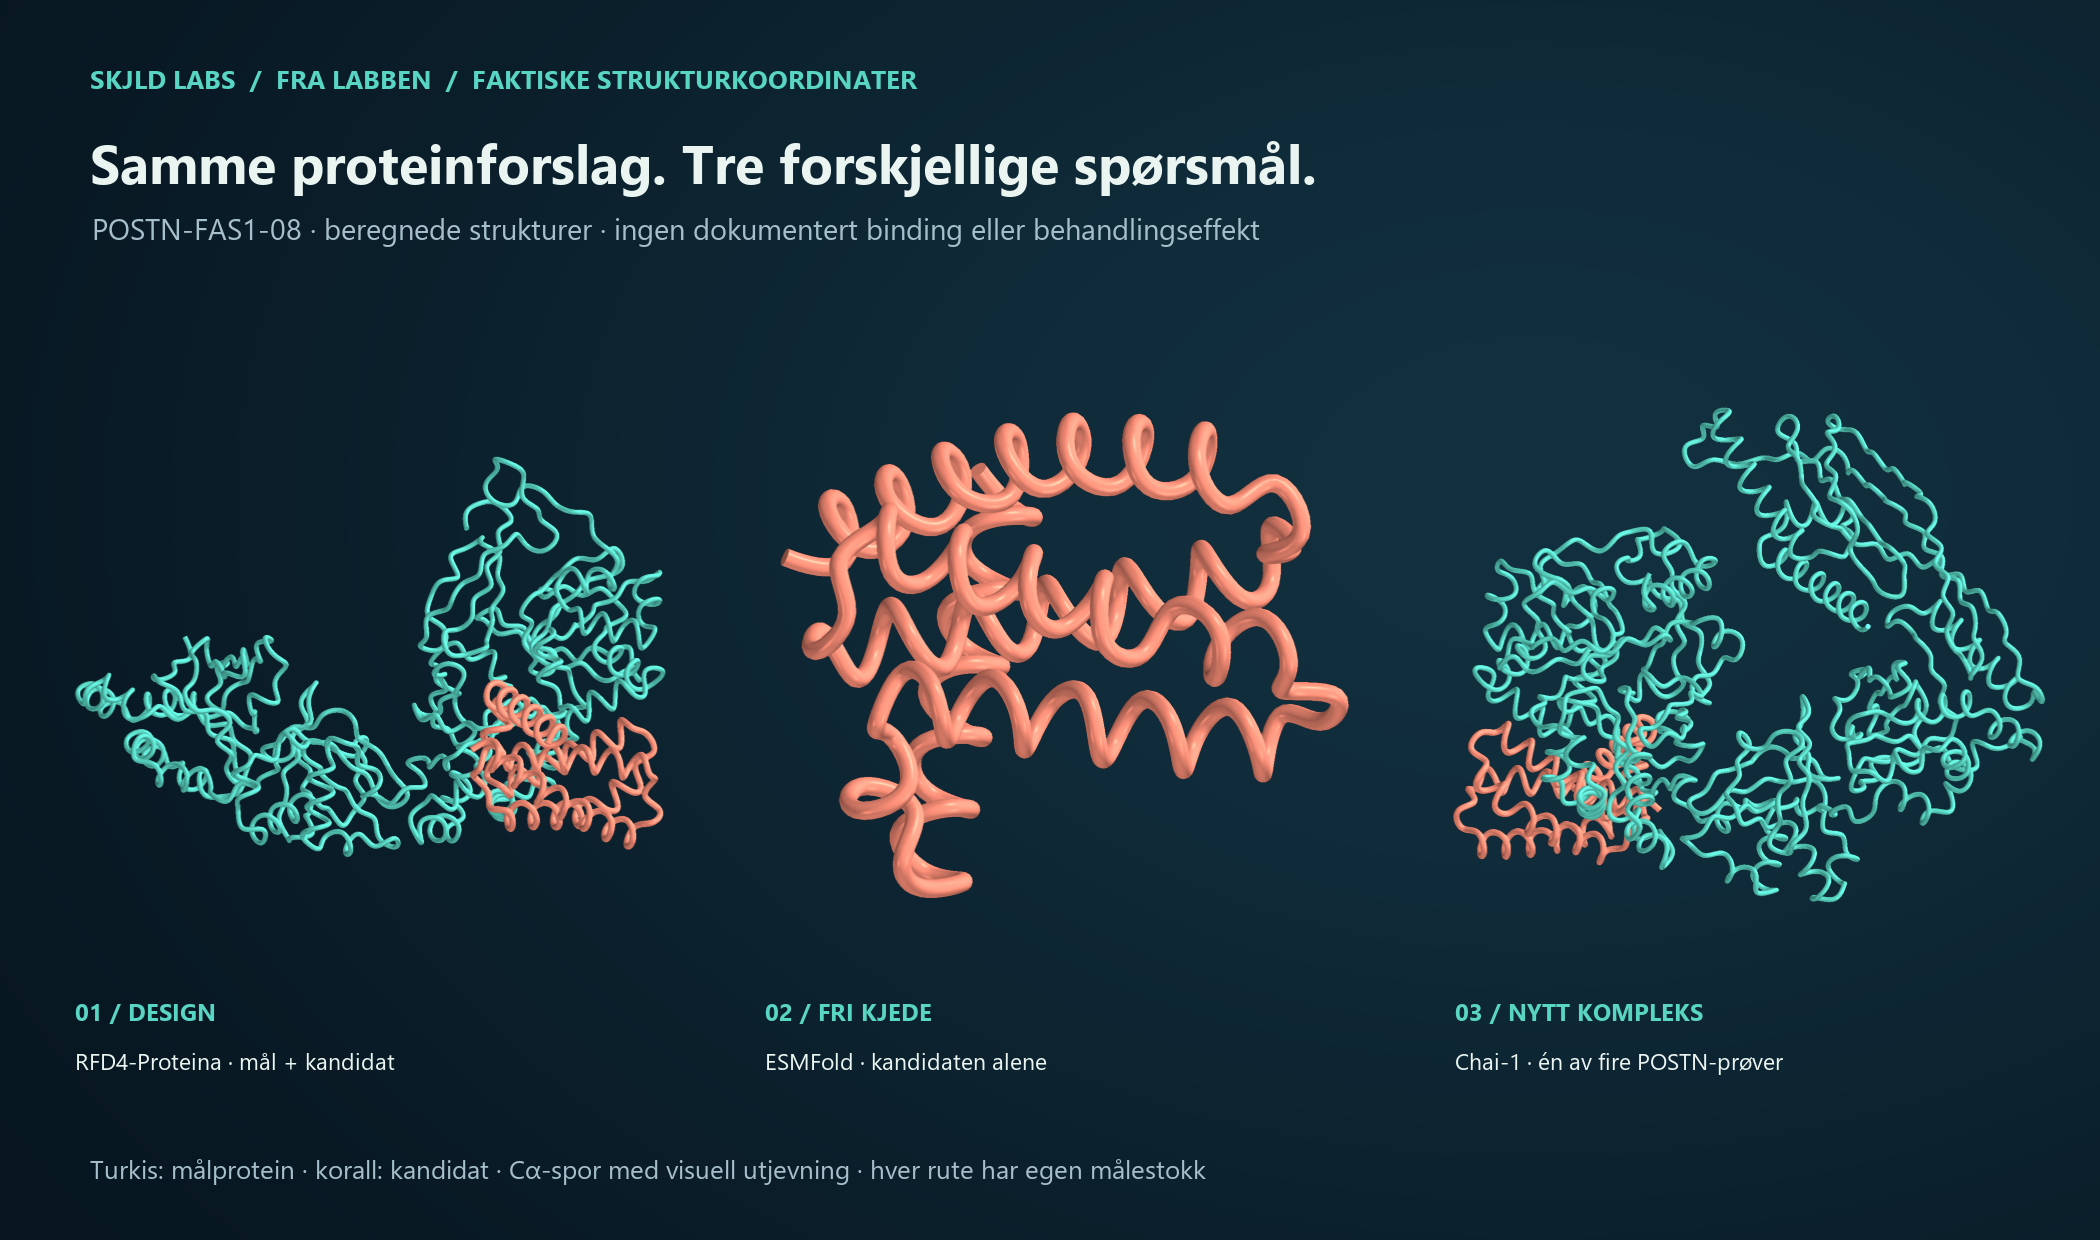
Vi har også laget en selvstendig 3D-visning av sju lagrede strukturfiler: RFD4-designet POSTN-FAS1-08, ESMFold av den frie kjeden, fire Chai-komplekser med periostin og den eksperimentelle referansen 5YJG. Det er flere visninger av samme kandidat og mål, ikke sju nye legemiddelkandidater.
Roter proteinstrukturene og bytt mellom modellprøvene →
Leseren kan slå målprotein og kandidat av og på, rotere, zoome og laste ned de viste koordinatene. Rotasjonen er en visningseffekt. Cα-kurvene kommer fra modellfilene; vi har ikke laget nye proteinprediksjoner for å få penere bilder. Dermed kan illustrasjonen brukes til å stille et konkret spørsmål om geometrien og samtidig beholde forbindelsen til kilden.
Proteiner er både sekvens, form og funksjon
Et protein er en kjede av aminosyrer. Rekkefølgen påvirker hvordan kjeden organiserer seg i rommet, hvilke overflater den presenterer, og hvilke andre molekyler den kan samhandle med. Når vi snakker om «proteinfolding» i denne serien, handler mye av det praktiske arbeidet om å forutsi en struktur. Det er ikke det samme som å simulere hele den fysiske foldingsprosessen over tid.
Gjennombruddet som AlphaFold2 demonstrerte i CASP14, viste hvor mye bedre strukturprediksjon kunne bli. Den historiske betydningen er at flere biologiske spørsmål kan undersøkes med nyttige strukturelle hypoteser. Det gjør ikke enhver ny modellstruktur riktig, og presisjon på en strukturbenchmark er ikke et mål på hvor mange medisiner en modell vil gi.
Design går et skritt videre enn å beskrive et eksisterende protein. Vi ber om et mulig nytt molekyl som skal passe til et bestemt formål. I vår showcase kan det være en binder mot et betennelsessignal, en kandidat mot et protein i arrvev eller et mulig utgangspunkt for en fluorescensprobe. Formålet bestemmer hvilke egenskaper som senere må vurderes.
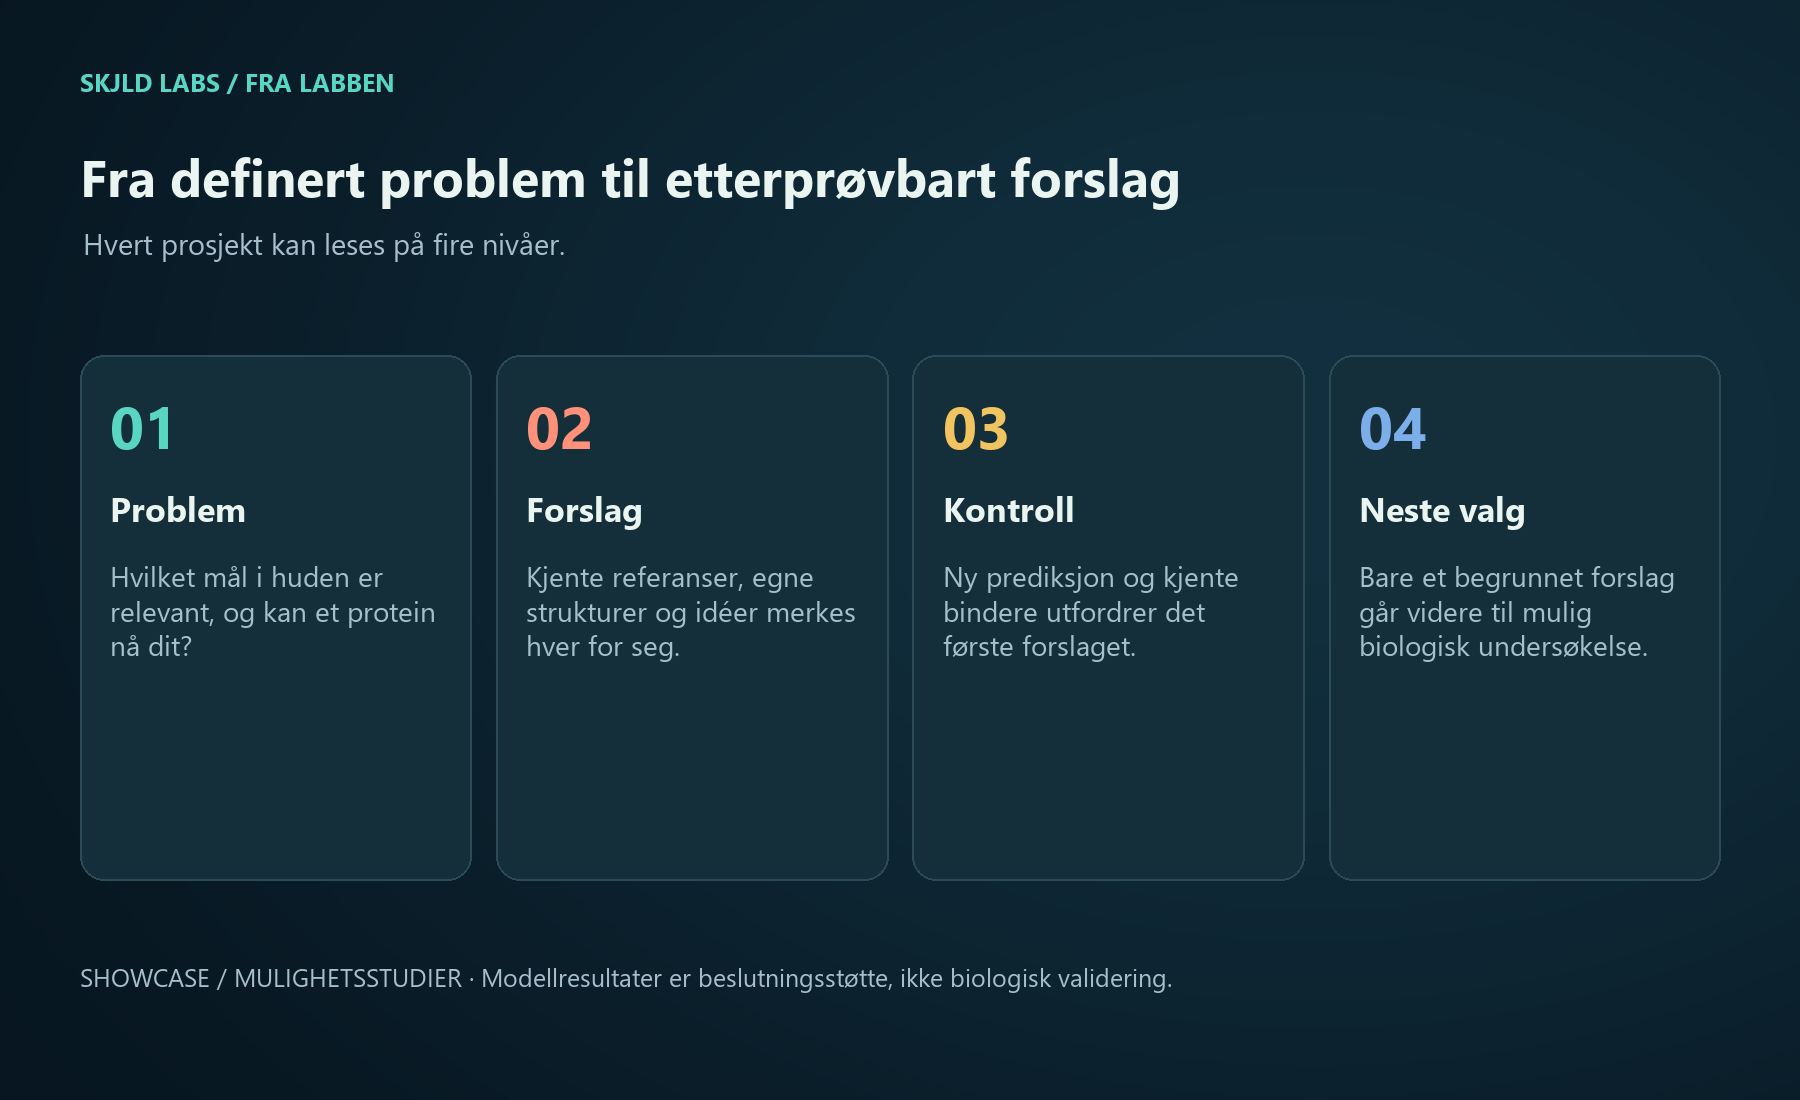
Fire spørsmål modellene hjelper oss å skille
| Oppgave | Modell i vårt arbeid | Hva svaret kan brukes til |
|---|---|---|
| Foreslå et nytt protein | RFD4-Proteina | Lage en sekvens og en mulig struktur i valgt kontekst |
| Vurdere en fri kjede | ESMFold | Undersøke om sekvensen får en lignende intern form |
| Undersøke et kompleks | Boltz og Chai | Sammenligne hvordan kandidat og mål plasseres |
| Vurdere biologisk effekt | Ingen modell har dokumentert dette i vår showcase | Krever et separat biologisk evidensgrunnlag |
RFD4-Proteina brukes i den generative delen: modellen foreslår sekvens og struktur i en valgt molekylær sammenheng. Vi brukte Diffusers-utgaven med dokumentert vektrevisjon. Forslaget er et mulig utgangspunkt for et protein, ikke et løfte om at det vil kunne produseres eller fungere.
ESMFold brukes til å undersøke en fri kjede ut fra sekvensen. Boltz og Chai-lab brukes i ulike runder til å undersøke komplekser. At en kandidat har en stabilt foreslått intern form, sier ikke at den legger seg riktig mot et målprotein. Derfor trenger vi begge typer spørsmål.
Dette er også grunnen til at vi skiller proteinmodellene fra bilde- og språkmodeller. En språklig forklaring kan organisere hypotesen og kildene, men er ikke en strukturprediksjon. Qwen-bildene i den tidligere illustrasjonssamlingen var visuelle konsepter. De nye figurene i artiklene er rendret fra koordinater eller data, med eksplisitt merking av hva som er beregnet, eksperimentelt referansemateriale eller syntetisk.
Arbeidet som faktisk er gjennomført
| Leveranse | Faktisk omfang |
|---|---|
| Opprinnelige HS/BCC/keloid-forslag | 108 proteinkjerner og 16 formatforslag |
| Opprinnelig Boltz-runde | 322 prediksjoner |
| Tidligere separat Chai-serie | 8 prøver |
| Senere Chai-runde | 312 av 324 planlagte prøver |
| Nye periostinforslag | 8 RFD4-design og 8 ESMFold-monomerer |
| POSTN/TGFBI-komplekser | 64 prøver, inkludert i de 312 ovenfor |
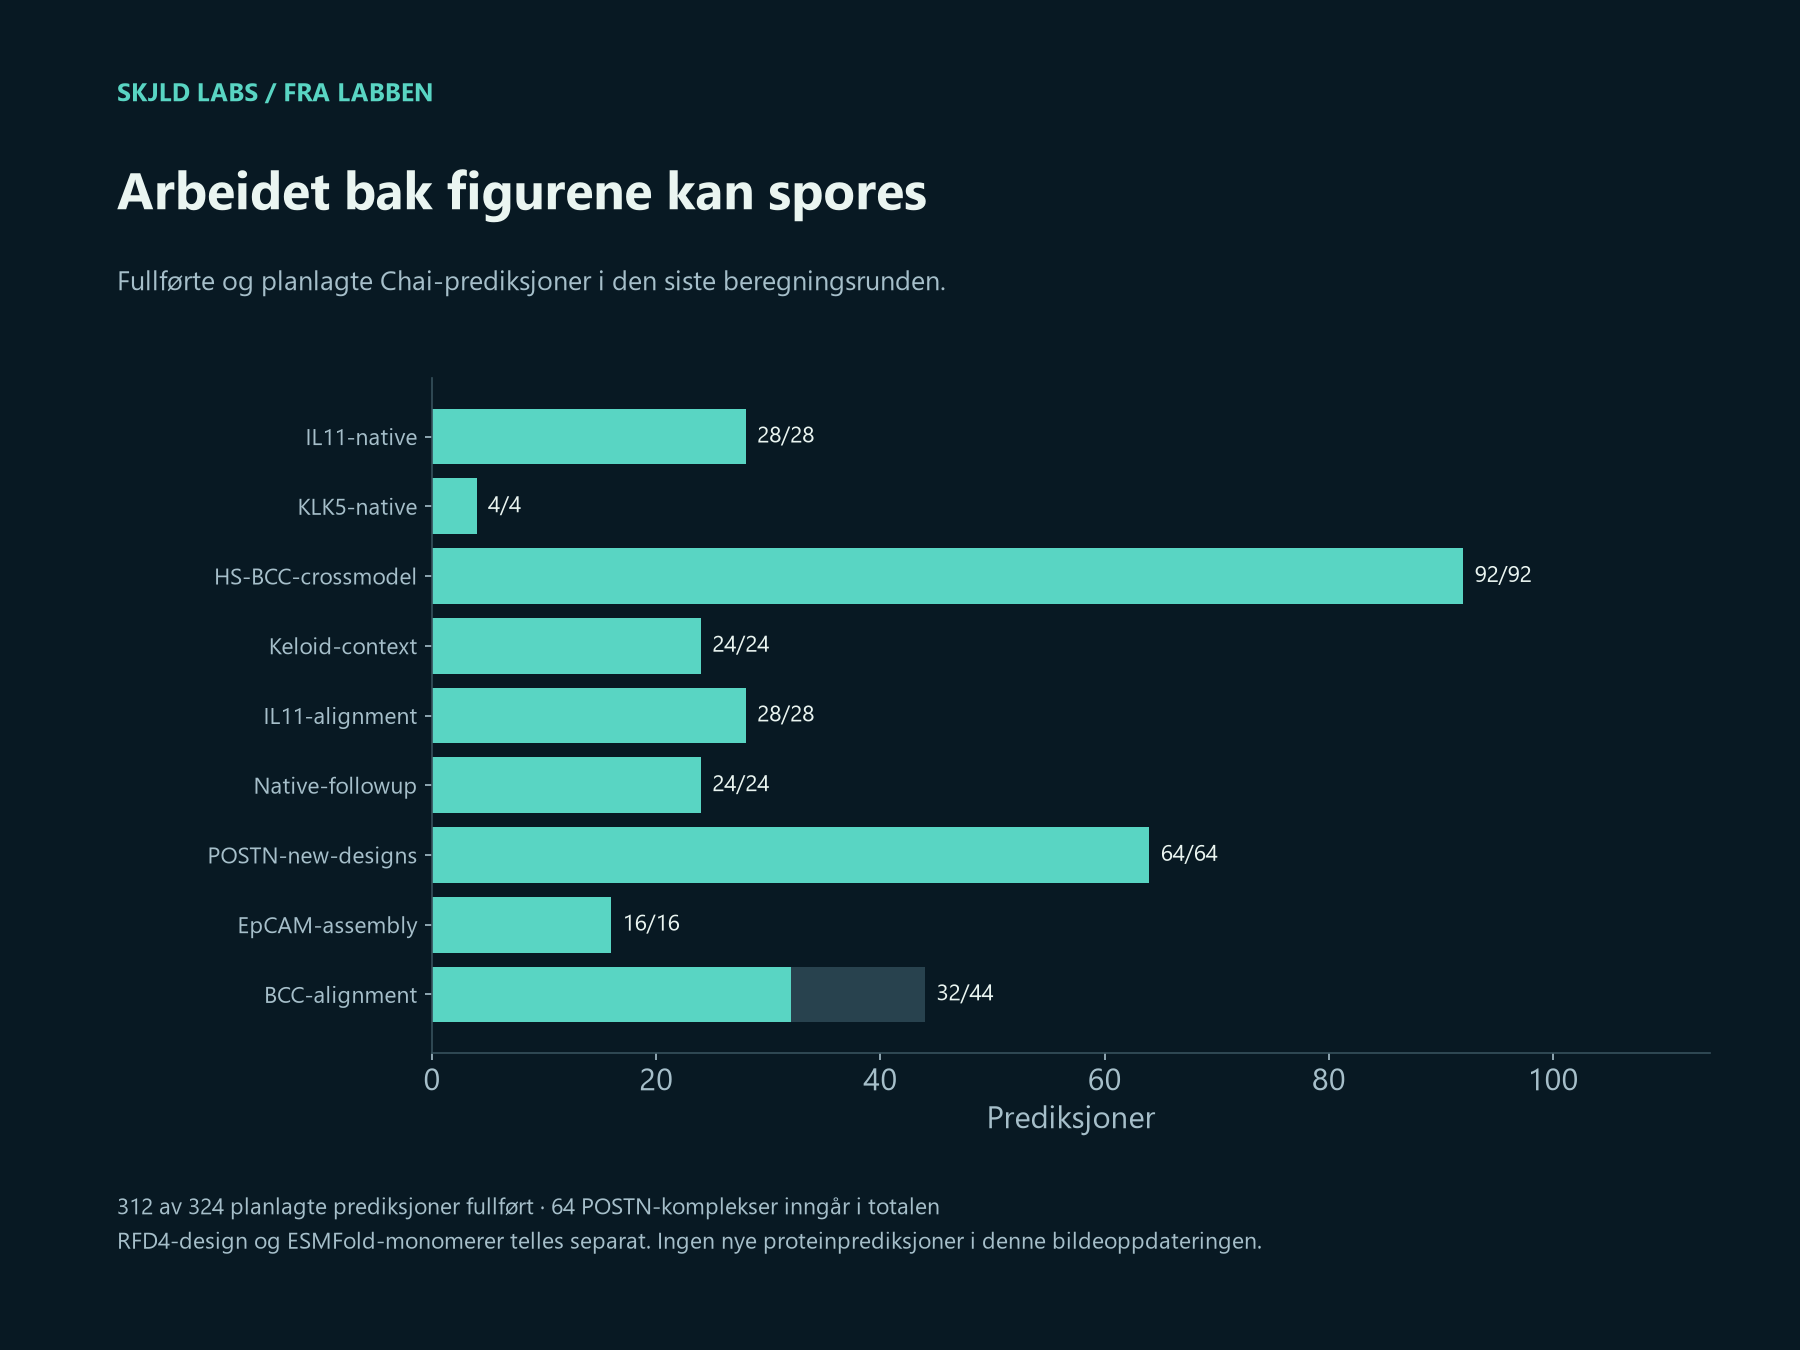
Enhetene i oversikten er viktige. En sekvens, en sammensatt formatidé og en prediksjon av et kompleks er tre forskjellige ting. Mange kompleksprøver kan undersøke den samme kandidaten. De 64 POSTN/TGFBI-prøvene inngår i tallet 312; de kommer ikke i tillegg. De siste tolv planlagte BCC-prøvene ble ikke kjørt og er ikke negative resultater.
De fem fagartiklene dekker både egne beregnede forslag og litteraturbaserte muligheter. Vi har egne design i HS-, BCC- og keloidprosjektene. Andre spor bruker kjente molekyler og biologiske referanser til å formulere hva et videre kandidatprosjekt burde undersøke. Nye bilder og denne redaksjonelle samlingen betyr ikke at det er kjørt nye proteinmodeller.
Styrke 1: Et forslag blir konkret nok til å kritisere
En generell idé om å «dempe arrdannelse» er vanskelig å etterprøve. Et konkret periostinforslag har derimot en sekvens, en struktur, en bestemt målregion og sporbare inngangsdata. Man kan undersøke om formen gjenskapes, om kontaktene overlever ny prediksjon, og om resultatet endrer seg når den molekylære sammenhengen endres.
I vår periostinrunde ga åtte design forskjellige resultater. Forslag 08 beholdt en betydelig del av designkontaktmønsteret i de fire POSTN-prøvene. De andre sju gjorde det ikke. Dette gir et tydeligere utgangspunkt for prioritering enn en mappe med åtte like overbevisende molekylbilder.
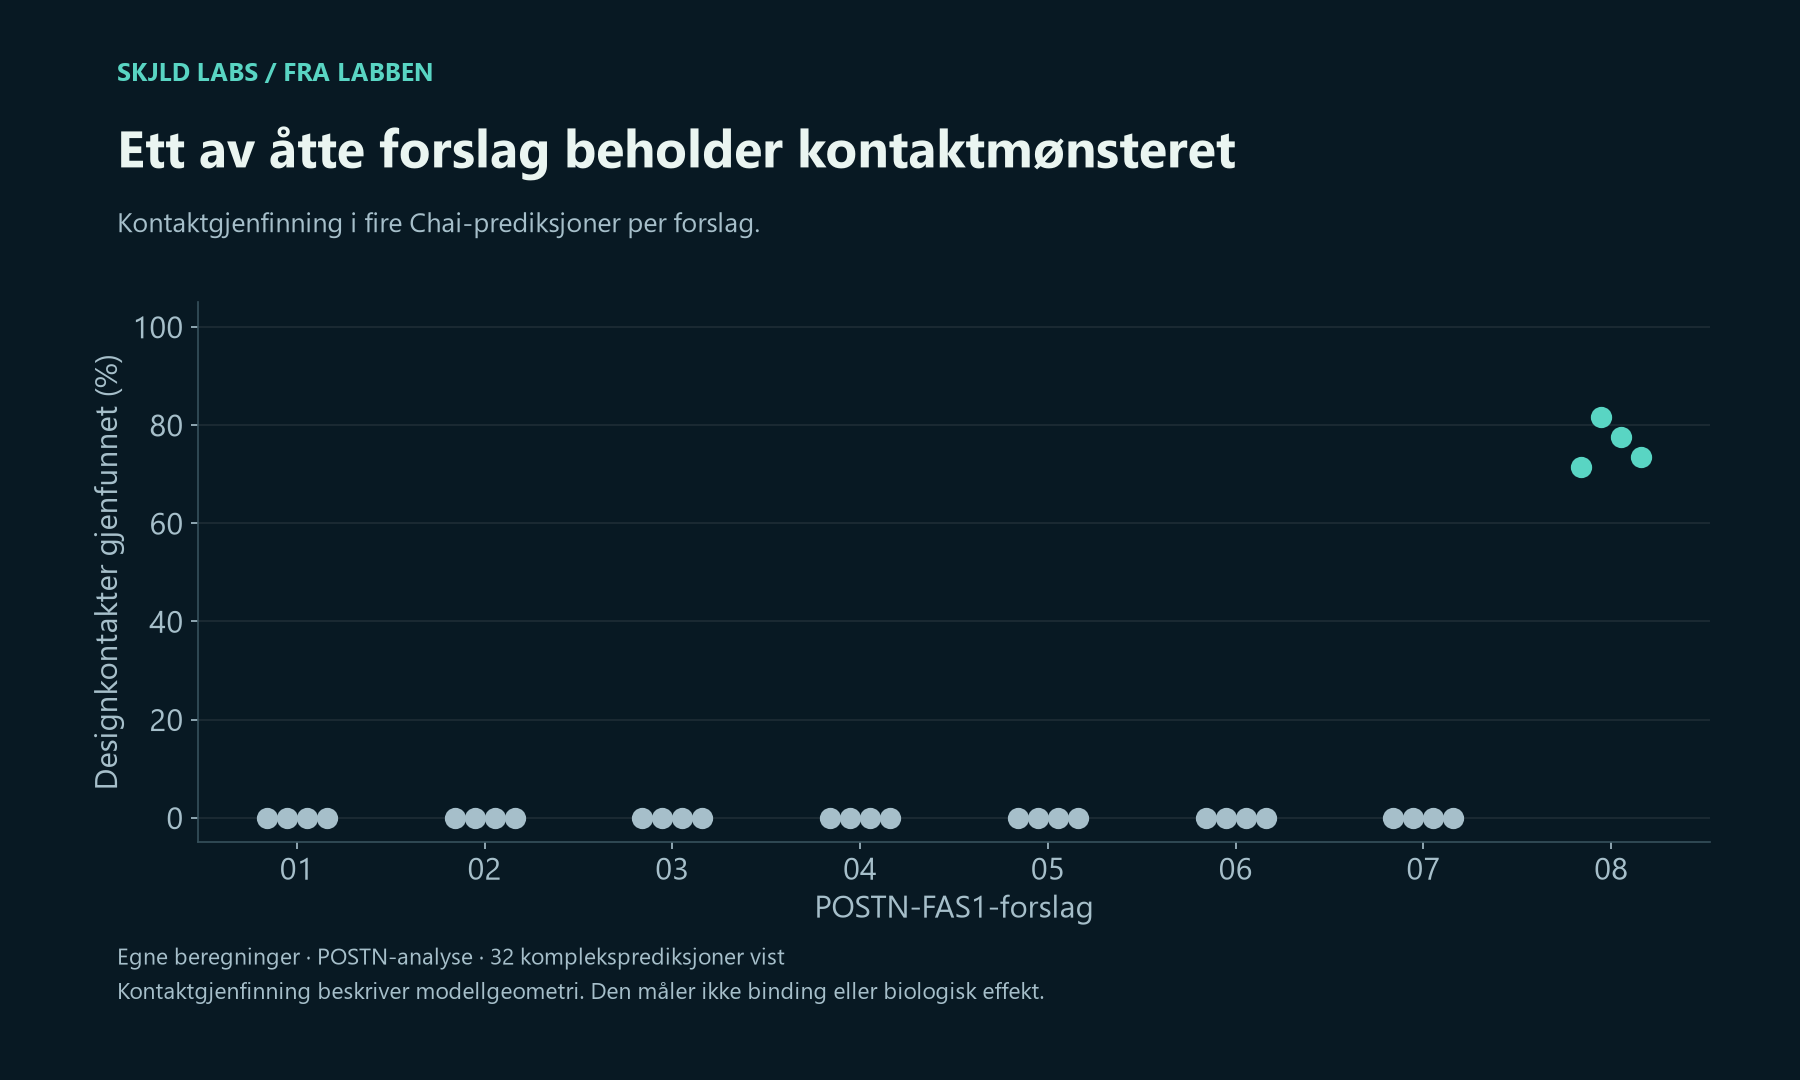
Grafen viser en forskjell i modellgeometri, ikke en biologisk suksessrate. Nettopp denne presisjonen gjør den nyttig: vi kan forklare hvorfor én kandidat vurderes nærmere, samtidig som binding, selektivitet og fibroblastrespons fortsatt står åpne.
Styrke 2: Vi kan undersøke følsomhet før et biologisk forsøk
En modell trenger et valgt utsnitt av virkeligheten. Hvilke kjeder er med? Er målsekvensen støttet av en alignering? Hvilke deler mangler i den eksperimentelle referansen? Vi kan undersøke om kandidatens støtte er robust for slike valg. Dette er særlig viktig når det første resultatet ser overbevisende ut.
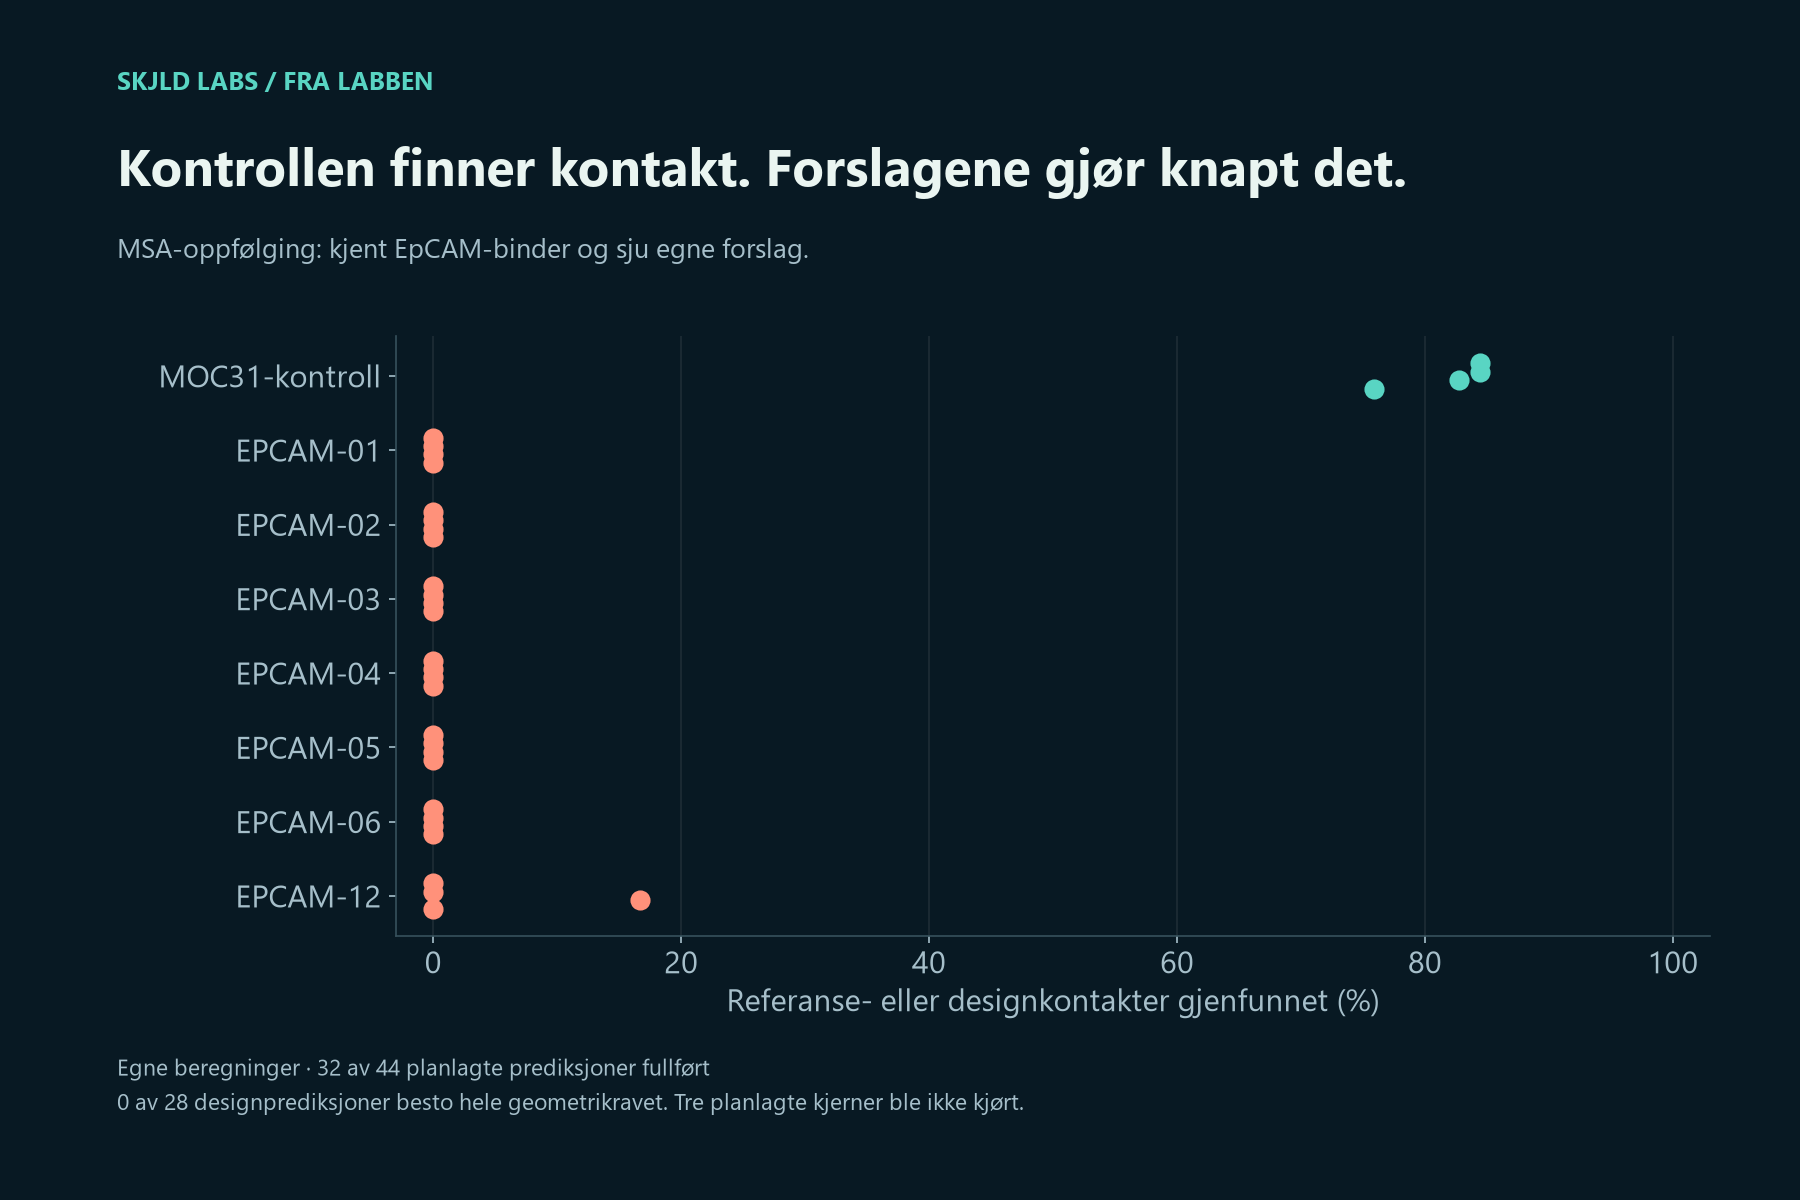
IL-11-sporet illustrerte at et forslag kunne miste designkontaktene da flere relevante reseptordeler ble tatt med. EpCAM- og TNF-kontroller viste at bedre sekvensgrunnlag kunne endre modellens rekonstruksjon av kjente kontakter. Slike sammenligninger er ikke biologiske forsøk, men hjelper oss å lokalisere hvilke antakelser en idé avhenger av.
Styrke 3: Flere relevante idéer kan sammenlignes systematisk
Proteinmodeller gjør det mulig å utforske mer enn én form eller kontaktidé. Det kan gi verdi når et kjent mål har en utfordrende overflate, når et mindre format er interessant, eller når flere relaterte mål må vurderes. Men et stort antall filer er ikke i seg selv fremgang. Sammenligningen må ha definerte spørsmål og inkludere resultater som svekker prosjektet.
Derfor har vi en søkbar oversikt med 23 kandidatkort fra 11 biologiske problemområder, nå formidlet i fem fagartikler. Kortene skiller publiserte referanseproteiner, egne beregnede forslag og konsepter uten ny sekvens. De viser også om formålet er behandling eller kartlegging. Et kort uten ny modellkjøring presenteres ikke som en nyoppdaget kandidat.
Tre tall som ofte blir misforstått
| Mål | Riktig lesemåte | Vanlig feiltolkning |
|---|---|---|
| pLDDT | Modellens anslag på lokal strukturpresisjon | Sannsynlighet for at et legemiddel virker |
| ipTM / grenseflateskår | Modellstøtte for relativ strukturplassering | Målt bindingsstyrke eller selektivitet |
| Kontaktgjenfinning | Andel referanse- eller designkontaktpar bevart i ny geometri | Andel biologisk aktivitet som hemmes |
Et kompleks kan dessuten få høy samlet modellstøtte fordi de naturlige målproteinene passer godt sammen, selv om den nye binderen ligger dårlig. Vi rapporterer derfor binderens egen kontakt til målet og legger ikke hele argumentet på én totalskår. Modellenes selvtillit må leses sammen med faktisk geometri og relevante kontroller.
Enighet mellom forskjellige modeller er heller ikke det samme som uavhengig eksperimentell bekreftelse. Modellene kan dele treningsgrunnlag, strukturelle antakelser og feilmønstre. Flere frø undersøker variasjon i en beregning; de skaper ikke flere uavhengige biologiske observasjoner.
Den siste delen av veien er medisinsk
En kandidat må kunne produseres og beholde ønskede egenskaper. Den må binde relevant, påvirke riktig funksjon og nå riktig sted i kroppen. Mulig nedbrytning, uønskede interaksjoner og immunrespons må også undersøkes. Disse spørsmålene blir ikke løst av at én fold ser riktig ut, og de er ikke målt i vår showcase.
Det betyr samtidig at modellene kan ha betydelig verdi tidlig. De kan gjøre det lettere å dele et presist forslag mellom klinikere, biologer og beregningsmiljøer, og å velge hva som fortjener mer kostbar undersøkelse. Vår hypotese om en kortere vei gjelder særlig denne overgangen fra problem til begrunnet shortlist. Vi har ikke målt tids- eller kostnadsbesparelse mot et tradisjonelt legemiddelprogram.
Det er dette potensialet serien demonstrerer: et sykdomsproblem kan kobles til konkrete proteiner, synlige antakelser og data som andre kan etterprøve. Den neste gevinsten avhenger av kvaliteten på de biologiske spørsmålene vi stiller, og av at modellresultatene får møte relevant eksperimentell motstand.
Finn og sammenlign de 23 kandidatkortene →
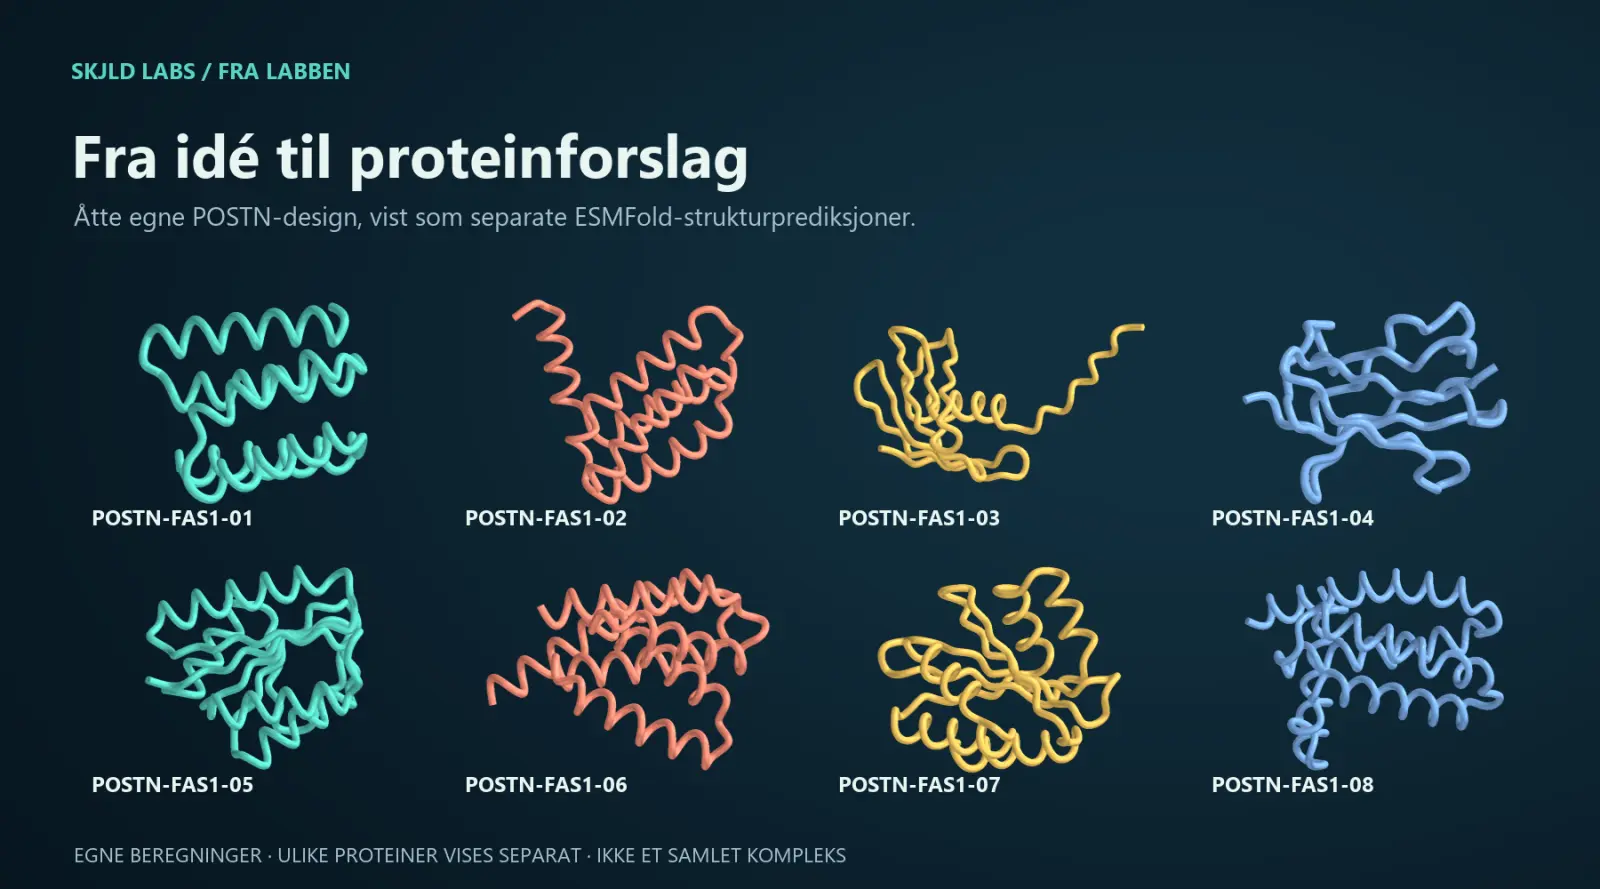
Om hovedbildet: Åtte egne periostinforslag, vist som separate ESMFold-monomerer. Ulike visningsfarger skiller kandidatene; de viser ikke konfidens eller effekt. Proteinene er ikke ett samlet kompleks.
Kilder og etterprøving
Les full metode og resultater · Last ned kode, tall og modellrepresentasjoner (ZIP, 6,3 MB) · Maskinlesbar kjøringsrapport.
Primærkilder er lenket ved påstandene de støtter. Figurgrunnlaget med kode og data, kontrollsummene og den fulle visnings- og dokumentasjonspakken kan lastes ned. De opprinnelige tolv artikkelversjonene er bevart som et datert arkiv.
Tekniske presiseringer om beregningene og figurene
Strukturfigurene følger Cα-posisjonene langs proteinkjeden. Linjene er glattet for visning, og manglende segmenter fylles ikke inn. Alle kjeder i et kompleks får samme rotasjon og forskyvning; binderen flyttes ikke separat for å passe bedre. Nærbilder viser binderen og observerte målkoordinater innen 18 Å. Fargene beskriver proteinroller, ikke aktivitet eller målt affinitet.
RFD4-Proteina ble brukt gjennom den dokumenterte Diffusers-vekten. Andre modeller var ESMFold v1, Boltz 2.2.1 og chai-lab 0.6.1. Boltz-affinitetshodet ble ikke brukt. RFD4- og ESMFold-kjøringer finnes for egne designspor; de litteraturbaserte sykdomssporene har ikke fått egne nye kandidatsekvenser.
De syntetiske transport- og kartmodellene har dimensjonsløse parametre. De er ikke kalibrert mot hud, biologisk behandling eller diagnostisk ytelse. Oppdateringen 18. november 2026 omfatter en ny Geneformer-kjøring på offentlige celledata og nye visualiseringer av tidligere proteinfiler. Det er ikke kjørt nye proteinprediksjoner eller utført biologiske forsøk i denne oppdateringen.
Opprinnelige modellantall, kontrolloppsett og vurderingsgrenser.