
Kompresjon er den nye GPU-oppgraderingen: hva NVIDIAs Puzzle-modell betyr for AI på egne servere
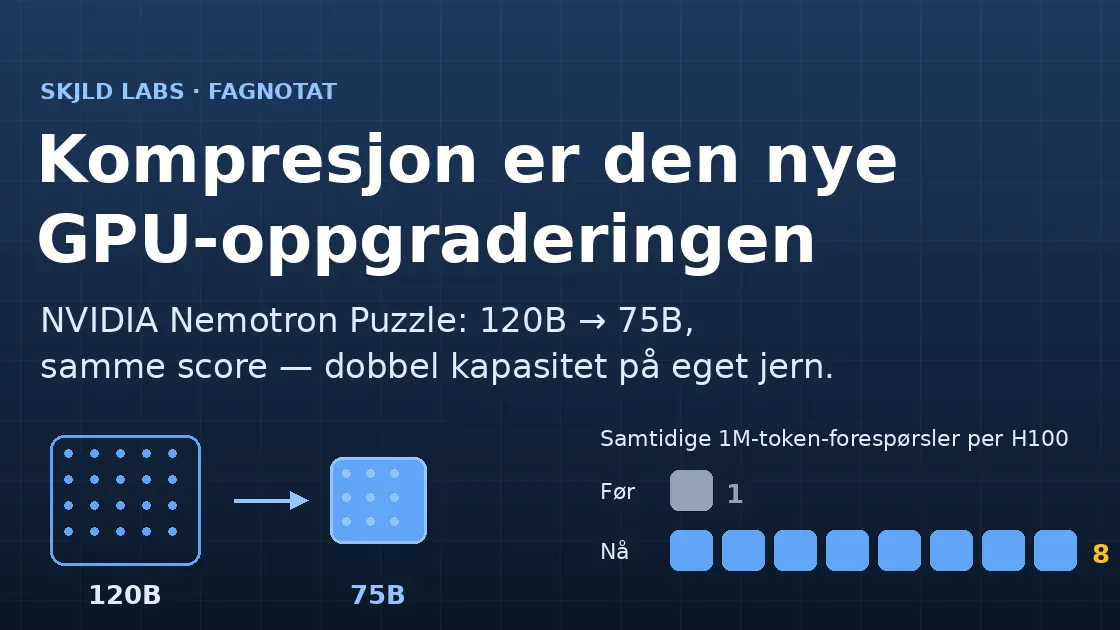
NVIDIA krympet Nemotron-3-Super fra 120 til 75 milliarder parametere, uten målbart tap i benchmarks. Resultatet: dobbel kapasitet på samme maskinvare, og åtte ganger flere samtidige 1M-token-forespørsler per H100. Vi forklarer hvordan Puzzle-kompresjon virker, og hvorfor dette gjør AI på egne servere stadig mer regningssvarende for norske virksomheter.
 Håkon TobroMedisinsk direktør og nevrolog
Den 6. juli slapp NVIDIA en modell med et navn bare en ingeniør kan elske: Nemotron-Labs-3-Puzzle-75B-A9B. Bak navnet skjuler det seg noe vi mener er viktigere enn nok en modellansering: et tydelig bevis på at kompresjon er i ferd med å endre regnestykket for alle som vil kjøre AI på egne servere.
Tallene som er verdt å stoppe ved
NVIDIA tok sin egen Nemotron-3-Super, med 120,7 milliarder parametere totalt og 12,8 milliarder aktive per token, og komprimerte den til 75,3 milliarder totalt og 9,3 milliarder aktive. Det interessante er ikke at modellen ble mindre. Det interessante er hva som ikke skjedde: benchmarks står i praksis stille. AIME25 går fra 89,7 til 89,9. MMLU-Pro fra 82,4 til 82,2. Lang kontekst (RULER ved 1 million tokens) går faktisk opp, fra 92,2 til 93,2.
Samtidig skjer dette med kapasiteten:
- Omtrent dobbel server-throughput på samme node, ved samme krav til svartid per bruker.
- Én H100 går fra å klare 1 samtidig forespørsel med 1M-token kontekst til 8.
Med andre ord: samme jern, åtte ganger flere tunge samtidige brukere. Det er en maskinvareoppgradering du laster ned i stedet for å kjøpe.
Hva NVIDIA faktisk gjorde, enkelt forklart
Metoden heter Iterative Puzzle, og grunnideen er at store modeller er ujevnt viktige innvendig. Noen lag gjør tungt løft. Andre kan slankes kraftig uten at noen merker det. I stedet for å kutte likt overalt, lærer Puzzle seg hvor modellen tåler kutt:
- Ujevn pruning av eksperter. Modellen er en Mixture-of-Experts, der hvert token bare aktiverer noen få «eksperter». NVIDIA reduserte både størrelsen på ekspertene og antallet som aktiveres, men ulikt fra lag til lag: følsomme lag beholder kapasiteten, robuste lag slankes hardt (fra 22 aktive eksperter ned til mellom 4 og 18, avhengig av laget).
- Destillering. Etter hvert kutt trenes den lille modellen til å etterligne originalen: titalls milliarder tokens med «fasit» fra moderen, inkludert egne treningsrunder på svært lang kontekst.
- Målrettet RL-reparasjon. Ferdighetene som er mest sårbare for kompresjon, altså koding og agent-arbeid, får en egen runde forsterkende læring for å hente inn tapet.
- Kvantisering. Til slutt pakkes vektene i 4-bits format (NVFP4) for nyeste GPU-generasjon, med FP8-variant for eldre kort.
Ingen av delene er ny for seg. Det nye er at hele kjeden nå er systematisert, dokumentert og reproduserbar, og at resultatet slippes åpent, med åpen lisens for kommersiell bruk og åpne treningsdata.
Hvorfor dette betyr noe i Norge
Vi har skrevet før om hvorfor ordene bør bli i Norge: amerikansk sky er underlagt CLOUD Act, og etter Schrems II er dataflyt ut av Europa et juridisk spørsmål, ikke bare et teknisk. Det sterkeste motargumentet mot AI på egen infrastruktur har hele tiden vært økonomi: toppmodeller krevde GPU-parker få norske virksomheter kan forsvare.
Det er dét regnestykket kompresjon endrer. Når en modell i 120B-klassen kan kjøres med 75B-kostnad, og hver GPU betjener åtte ganger så mange tunge forespørsler, faller prisen per bruker tilsvarende. Åpne, komprimerte modeller med millionlang kontekst, verktøybruk og agent-evner er nå noe en mellomstor norsk virksomhet kan drifte selv: på leid norsk jern, i eget datarom, eller hos noen som gjør det for dem. Dataene trenger aldri forlate landet.
De ærlige forbeholdene
Fagnotat betyr også å si det som ikke står i pressemeldingen. NVFP4-formatet gir full effekt først på nyeste GPU-generasjon (Blackwell). På H100 er FP8-varianten det realistiske valget. 75 milliarder parametere er fortsatt seriøs maskinvare. Dette er ikke hobbymaskin-territorium. Og benchmarks er ikke din arbeidshverdag: en komprimert modell skal alltid testes på dine oppgaver, ditt fagspråk og dine sikkerhetskrav før den settes i produksjon. Kompresjon kan svekke akkurat den evnen du er avhengig av, selv når snittet ser uendret ut.
Det er her vi kommer inn
Dette er kjernen i det vi driver med hos Skjld Labs. Vi drifter allerede åpne modeller og agenter på egen infrastruktur i Sandefjord. Det er motoren bak Skjld Diktat, og samme håndverk som ligger bak AI-systemene og agentene vi bygger og hoster for kundene våre. Vi følger modellslippene, evaluerer dem mot reelle arbeidslaster, og vet hva som skal til for at en åpen modell passerer en revisjon, ikke bare en demo.
Lurer du på om AI på egne servere er regningssvarende for din virksomhet: hva det koster, hvilken modell som passer, og hva som kreves av drift og sikkerhet? Book en gratis samtale, eller les mer om AI-rådgivningen vår. Vi forteller deg hva vi ville bygget først, og hva som er overkill.
Kilder: modellkortet på Hugging Face og NVIDIAs tekniske rapporter om Puzzle og Nemotron 3.