
Ingen KI-modell er best i alt. Derfor tester vi dem på egne oppgaver før utrulling
Vi satte fem lokale språkmodeller til fem ekte arbeidsoppgaver på norsk, og lot dem dømme hverandre blindt, uten at ett token forlot huset. Hver modell viste sin egen styrkeprofil. Og det viktigste funnet handlet ikke om modellene, men om kunnskapen som kreves for å bruke dem riktig.
 Jon Gottfred AndersenStyreleder og hudlege
Modellkort og benchmarks forteller deg hvordan en språkmodell presterer på engelsk, på generiske oppgaver, på sin beste dag. De forteller deg ikke hvordan den håndterer norsk fagspråk, dine formatkrav eller ditt jern.
Vi kjører modellflåten vår lokalt: fire modeller bak en LiteLLM-proxy, pluss den store Qwen3.5-122B. Før noen modell får en jobb hos oss, må den vise hva den kan på våre oppgaver. Denne gangen delte vi metoden og tallene, og det tallene viste, var ikke én vinner, men fem ulike styrkeprofiler. Det viktigste funnet handlet ikke om modellene i det hele tatt.
Oppsettet
Fem åpne modeller, alle på eget jern:
Gemma-4-26B: 26 mrd (4 mrd aktive) · MoE
Qwen3.6-35B: 35 mrd (3 mrd aktive) · MoE
Nemotron-3-Puzzle-75B: 75 mrd (9 mrd aktive) · hybrid MoE (Mamba-Transformer, NVFP4)
Qwen3.5-122B: 122 mrd (10 mrd aktive) · MoE
Agents-A1: 35 mrd · Qwen-basert MoE-agentmodell (InternScience, Apache 2.0)
Fem ekte oppgaver, på norsk: strukturert innsikts-ekstraksjon fra podkast- og nyhetstranskripter, kildetro spørsmål-og-svar med sitatplikt, syntese av ukesinnsikt, kvalifisering av bedriftsleads med begrunnelse, og strategibrief for førstekontakt. Samme frosne oppgavesett til alle. Mer om hvorfor den formuleringen er verdt å merke seg, i sjekklisten. Alle selskapsdetaljer er anonymisert her.
Og dømming uten å ringe en sky: hvert svar ble anonymisert og blindt vurdert av tre modeller som ikke skrev det. Fem akser (faktatro, innsiktsverdi, instruksjonsetterlevelse, norsk språk, handlingsbarhet), median som fasit. Ingen dommer visste hvem som skrev hva. Ingen dømte seg selv. Panelet var påfallende samstemt om rangeringen (rangkorrelasjon 0,69-0,89 mellom dommerne), men er ikke menneskekalibrert. Les tallene som rangering, ikke karakterbok.
Tallene
Panel-score 0-100, median av tre blinde dommere. Rekkefølge: Gemma-26B / Qwen-35B / Nemotron-75B / Qwen-122B / Agents-A1. Uthevet = best.
Innsikts-ekstraksjon: 41 / 43 / 39 / 51 / 36
Kildetro Q&A: 56 / 43 / 37 / 53 / 41
Norsk syntese: 64 / 55 / 60 / 72 / 45
Lead-kvalifisering: 75 / 97 / 81 / 82 / 98
Strategibrief: 100 / 93 / 99 / 100 / 99
Tokens/sekund: 39 / 43 / 25 / 130 / 43
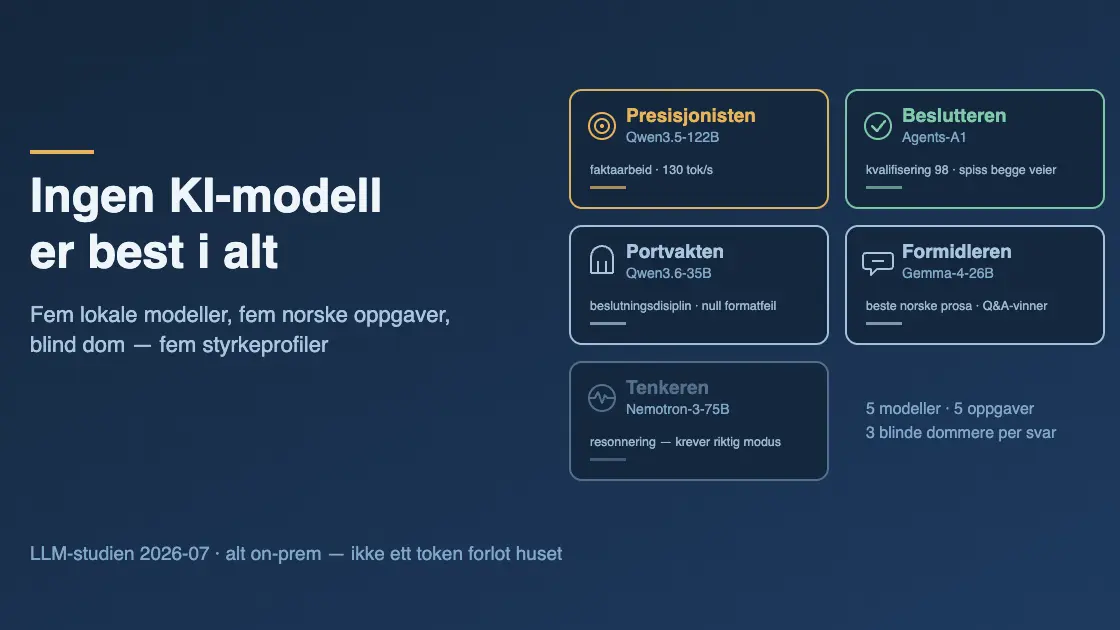
Fem modeller, fem oppgaver, og fem ulike styrkeprofiler.
Styrkeprofilene
Qwen3.5-122B: presisjonisten. Vant ekstraksjonen og syntesen, nest best på kildetro Q&A, full pott på strategibrief: ren JSON uten dikkedarer, ordrette sitater, færrest fabrikasjoner. Og her ryker den første intuisjonen: den største modellen var også den klart raskeste (130 tokens/sekund): MoE-arkitekturen aktiverer bare 10 av 122 milliarder parametre per token, og serving-stakken vår utnytter det godt (mer om hvorfor parametertall ikke forutsier fart, under driftslærdommene). Skal du ha én modell til strukturert faktaarbeid i volum, ser du etter denne profilen.
Agents-A1: beslutteren. En 35-milliarders MoE-agentmodell fra InternScience (Qwen-basert, Apache 2.0), trent spesifikt for lange agent-forløp: treningsbanene er i snitt 45 000 tokens, og seks agentdomener er destillert inn i én modell via flerlærer-destillasjon. Ambisjonen deres er frontier-ytelse i agentoppgaver fra en 35B-modell, og hos oss toppet den kvalifiseringen (98 av 100): klare verdikter, presise produktvalg, begrunnelser som står til fakta. Men snu arket: på kildetro analysearbeid var den svakest i feltet (36 på ekstraksjon, sist totalt i innsiktssporet). En spisset modell er spiss begge veier. Profilen avgjør hvor den hører hjemme, ikke gjennomsnittet. Og bare testing avslører hvilken vei spissen peker.
Qwen3.6-35B: portvakten. Hakk i hæl på beslutteren (97 på kvalifisering), med den samme strenge beslutningsdisiplinen: der andre sa «kanskje», tok den avgjørelsen, og droppet to tredjedeler av kandidatene. Null formatfeil gjennom hele testen. Når et menneskes tid er flaskehalsen nedstrøms, er streng portvakt en styrke, ikke en svakhet.
Gemma-4-26B: formidleren. Vant kildetro Q&A og delte toppplassen på strategibriefene (100): den mest naturlige norske prosaen i feltet, tekst med retning, adressat og konkret vinkling. Også den mest optimistiske vurdereren: den ville forfulgt halvparten av kandidatene, en egenskap du vil ha i kreativt arbeid og må kompensere for i portvakt-roller. Blant de minste i feltet, og nummer to totalt på innsiktsarbeidet. Riktig modell til riktig jobb slår rå størrelse.
Nemotron-3-Puzzle-75B: tenkeren, og testens lærepenge. En hybrid Mamba-Transformer MoE-resonneringsmodell (9 mrd aktive parametre, komprimert fra 120 mrd med NVIDIAs Puzzle-rammeverk) bygget for dyp, flerstegs analyse med tenkemodus på, som testen bevisst slo av, for lik sammenligning. Utenfor sitt element leverte den midt på treet der oppgavene lignet resonnering (60 på syntese, 99 på strategibrief) og svakest der de krevde kildetro hurtigarbeid. Det er ikke en dom over modellen. Det er poenget med å teste: konfigurasjonen en modell rulles ut med, kan avgjøre hvor den havner. Én presisering hører med: tenkemodus ble ikke målt her, så hvor mye den ville hentet inn, vet vi ikke. Det krever en egen test med tenketid i budsjettet.
Temperamentene fortjener sin egen oversikt, for de er en beslutning man arver enten man vil eller ikke. Samme tolv leads, fem fordelinger (forfølg / kanskje / dropp):
Gemma-26B: 6 / 5 / 1
Qwen-35B: 4 / 0 / 8
Nemotron-75B: 5 / 7 / 0
Qwen-122B: 3 / 9 / 0
Agents-A1: 4 / 0 / 8
Gemma er salgsoptimisten. Beslutteren og portvakten er de to strenge: identisk fordeling, klare beslutninger. Og de to «kanskje»-tunge modellene skyver i praksis avgjørelsen tilbake til et menneske: ni av tolv «kanskje» er ikke forsiktighet, det er ubetalt operatørtid.
De to driftslærdommene
Thinking-skatten. Første testkjøring feilet nesten halvparten av kallene mot resonneringsmodellene: de brukte hele token-budsjettet på intern tenking og leverte tomt svar, til full pris. Én konfigurasjonslinje (eksplisitt tenkemodus-styring) skilte ubrukelig fra utmerket. Dette står ikke i modellkortet.
Spec-arket forteller ikke gjennomstrømningen. To av modellene er MoE med nesten likt antall aktive parametre, 9 og 10 milliarder, men leverte 25 mot 130 tokens/sekund på vårt oppsett. Kvantiseringsformat, serving-stack og kernel-støtte for akkurat din maskinvare betyr mer enn både parametertall og arkitekturkolonnen. Regn kost som målt gjennomstrømning på eget jern, aldri som spec.
Gemma-4-26B: 39 tok/s · snittlatens 7,0 s
Qwen3.6-35B: 43 tok/s · 7,0 s
Nemotron-3-Puzzle-75B: 25 tok/s · 13,4 s
Qwen3.5-122B: 130 tok/s · 2,4 s
Agents-A1: 43 tok/s · 6,9 s
Riktig modell til riktig jobb gjelder også innkjøpet
Styrkeprofilene peker mot et spørsmål som avgjøres lenge før noen prompt skrives: hva slags jern trenger du egentlig? Det er lett å bruke en halv million kroner på en GPU-server som kan kjøre de største åpne modellene. Men de minste modellene i testen får plass på en kompakt arbeidsstasjon i 50 000-kronersklassen, som Dell Pro Max GB10. Det gjelder 26B- og 35B-klassen, inkludert Agents-A1.
Beste modell per prisklasse og oppgave (liten boks ~50 000 kr mot GPU-server ~500 000 kr):
Innsikts-ekstraksjon: Qwen-35B 42,7 mot Qwen-122B 51,3. Liten boks gir 83 %
Kildetro Q&A: Gemma-26B 56,0 mot Qwen-122B 53,3, 105 %
Norsk syntese: Gemma-26B 64,0 mot Qwen-122B 72,0, altså 89 %
Lead-kvalifisering: Agents-A1 98,3 mot Qwen-122B 82,0, 120 %
Strategibrief: Gemma-26B 100,0 mot Qwen-122B 100,0, 100 %
(Prosentene bygger på panel-scorer som ikke er menneskekalibrerte. Les dem som størrelsesorden. Prisklassene er omtrentlige.)
På ekstraksjon og syntese gir den store serveren en reell, men moderat gevinst: den lille boksen leverer 83-89 prosent av kvaliteten for rundt en tidel av maskinvareprisen. På kildetro Q&A, kvalifisering og strategibrief matchet eller slo de små modellene den store, og på kvalifisering var det nettopp den spissede 35B-agentmodellen som slo alt. Poenget er ikke at små bokser alltid holder. Det er at pris/ytelse-kurven er oppgaveavhengig og ikke kan leses av et spec-ark. For mange virksomheter dekker en boks i 50 000-kronersklassen de fleste hverdagsoppgavene. Hvilke oppgaver som faktisk trenger det store jernet, finner du bare ut ved å måle.
Sjekklisten vår før en modell får en jobb
- Test på egne oppgaver, på eget språk: benchmarks måler ikke norsk fagtekst eller dine formatkrav.
- Test i riktig modus: tenkemodus, temperatur og token-budsjett er del av modellvalget, ikke detaljer man ordner etterpå.
- Frys oppgavesettet: skal modeller sammenlignes over tid, må de møte nøyaktig samme oppgaver. (Ja, vi lærte dette underveis: første versjon av testen bygde oppgaver fra levende produksjonsdata, og settet driftet. Hele studien ble kjørt på nytt.)
- Mål kost som tokens/sekund på eget jern: hverken totale eller aktive parametre forutsier gjennomstrømning.
- Velg temperament bevisst: optimist, portvakt eller ubesluttsom. Pipelinen arver modellens personlighet enten du har valgt den eller ikke.
- La modellene dømme hverandre, blindet: et lokalt dommerpanel koster strøm og gir deg rangeringer uten at sensitive data forlater huset.
Hvorfor dette angår din bedrift
Hele eksperimentet, generering og dømming, kjørte på eget jern, på ekte data. Ingen sky-leverandør så et eneste token. Regningen var strøm.
Det er den egentlige gevinsten ved suveren KI: ikke bare at dataene bor hjemme, men at du kan eksperimentere fritt med dem: teste, måle og tilpasse modeller mot dine faktiske oppgaver før de får ansvar. Kunnskapen om å gjøre nettopp det er forskjellen på en modell som skuffer og en flåte som leverer. En kompetent liten stab med egen infrastruktur gjør en slik test på en dag, og kjører den på nytt neste gang en lovende modell dukker opp, på nøyaktig samme oppgaver.
Metode i korthet: 32 frosne oppgaver × 5 modeller = 160 genereringer via lokal gateway, temperatur 0,2, tenkemodus av. Blind dømming: tre ikke-forfatter-modeller per svar, 5-akse-rubrikk, median (449 gyldige dommer-kall av 450). Begrensninger: 30 dømte oppgaver per modell, LLM-panel som dommer (ikke menneskekalibrert, og tre av fem modeller er i Qwen-familien, delt skjevhet mulig), resonneringsmodellens tenkemodus ikke målt og ytelse målt under normal last.